GB10で動く中小企業向けプライベート AI アシスタント: mesures
GIGABYTE AI TOP ATOM(NVIDIA GB10 チップ、128 GB)上で、完全なソフトウェアスタック(Open WebUI インターフェース、gpt-oss 120B モデル、検索モデル bge-m3)は 66 秒で起動し、68 GB を使用します。5,000 ページを 6 分でインデックス化し、500 ページでは 86 %(5,000 ページでは 78 %)のケースで正しい文書を見つけ、一人の質問には 10 秒で回答します。200 回の回答の間、どのコンテナも外部へパケットを送信しませんでした。各回答のコストは GPU 側で 0.15 Wh です。
契約書や業務手順をAIで照会したい中小企業は、すぐに「自社のドキュメントはどこへ送られるのか?」という疑問を抱きます。プライベートアシスタントなら、すべてをオフィスのマシン上に保持できます。その仕組みはRAG(検索拡張生成)です。システムはまずファイルの中から役立つ箇所を検索し、その後モデルが回答を作成します。私たちは、GIGABYTEから無償提供されたAI TOP ATOM上で、架空の企業のドキュメントを使ってスタック全体を測定しました。
#スタックの構成:三つのソフトウェア、68 GB
プライベートアシスタントは三つの構成要素から成り、当社はそれらを AI TOP ATOM(型番 ATAGB10-9000、DGX OS 7.5.0)上の Docker コンテナにインストールしました。モデルは llama.cpp(ビルド 11430)で動作します。
- Open WebUI 0.11.4
- Web インターフェースです。アカウント、ファイルのインポート、ナレッジベース、会話を扱います。文書を抜粋(デフォルトでは 1,000 文字、重複 100 文字)に分割し、各質問に最も近い 5 つの抜粋を保持するのもこのコンポーネントです。
- gpt-oss 120B(MXFP4)
- Le modèle qui rédige la réponse, servi par llama-server (le serveur fourni avec llama.cpp). MXFP4 est son format d'origine, déjà compressé. Il est réglé pour 10 demandes en parallèle. C'est un modèle MoE (mélange d'experts) : à chaque token, il n'utilise que 5,1 de ses 117 milliards de paramètres.
- bge-m3(Q8_0)
- 埋め込みモデルで、ここでは Q8_0 版(8 ビット量子化)を使用しています。各抜粋をその意味を表す数値の列に変換し、質問と抜粋を比較できるようにします。多言語対応のため、フランス語にも適しています。
ディスクキャッシュを消去した状態からの完全な起動は、インターフェースが使用可能になるまで 66 秒かかりました。スタックのメモリ使用量は 68.0 GB で、そのうち gpt-oss 120B プロセスが GPU 側で 63.6 GB、bge-m3 が 0.8 GB を占め、残りは Open WebUI とシステムによるものです。
起動後、マシンには 48.6 GB の空きメモリが残ります。このガイドのメモリ容量は、Linux の表示と同じく GB 単位で記載しています(1 GB = 1,024 MB)。本シリーズの最初のガイドでは、gpt-oss 120B の速度(毎秒 58 トークン)を詳しく解説しています。
#架空の企業と 100 の質問
私たちの経験とガイド付きルートを活かして、ローカルRAGを構築し、自分のドキュメントで活用しましょう。
- 永久に利用できるオンラインスペース
- PDF + ファイル
- 30日間返金対応
Lustrelleは私たちが考案した架空の中小企業で、作業場、倉庫、アフターサービス部門、オフィスを持っています。60件のドキュメントはMarkdown形式のテキストファイル(見出しやリストを示すいくつかの記号を含むシンプルなテキスト)です。内容は人事、作業場の安全、バックアップ、経費精算、顧客からの返品、研修計画などです。各回答を検証できるよう、具体的な数値、名前、条件が含まれています。
現実的な規模にするため、プロトコルの定めに従って、Service-Publicの公開解説ページを追加しました。これにより、サイズが段階的に大きくなる三つのナレッジベースができました。本ガイドの手法に関する詳細は、アシスタントが最初の回答を出す前の2026年10月7日付のプロトコル補遺で定めています。プロトコルは最初の測定の前に確定しており、手法、日付入りの補遺一覧、表のデータは手法のページで公開しています。
| Base | ファイル | コンテンツ |
|---|---|---|
| 50 ページ | 26 | Lustrelleの60件のドキュメントのうち26件 |
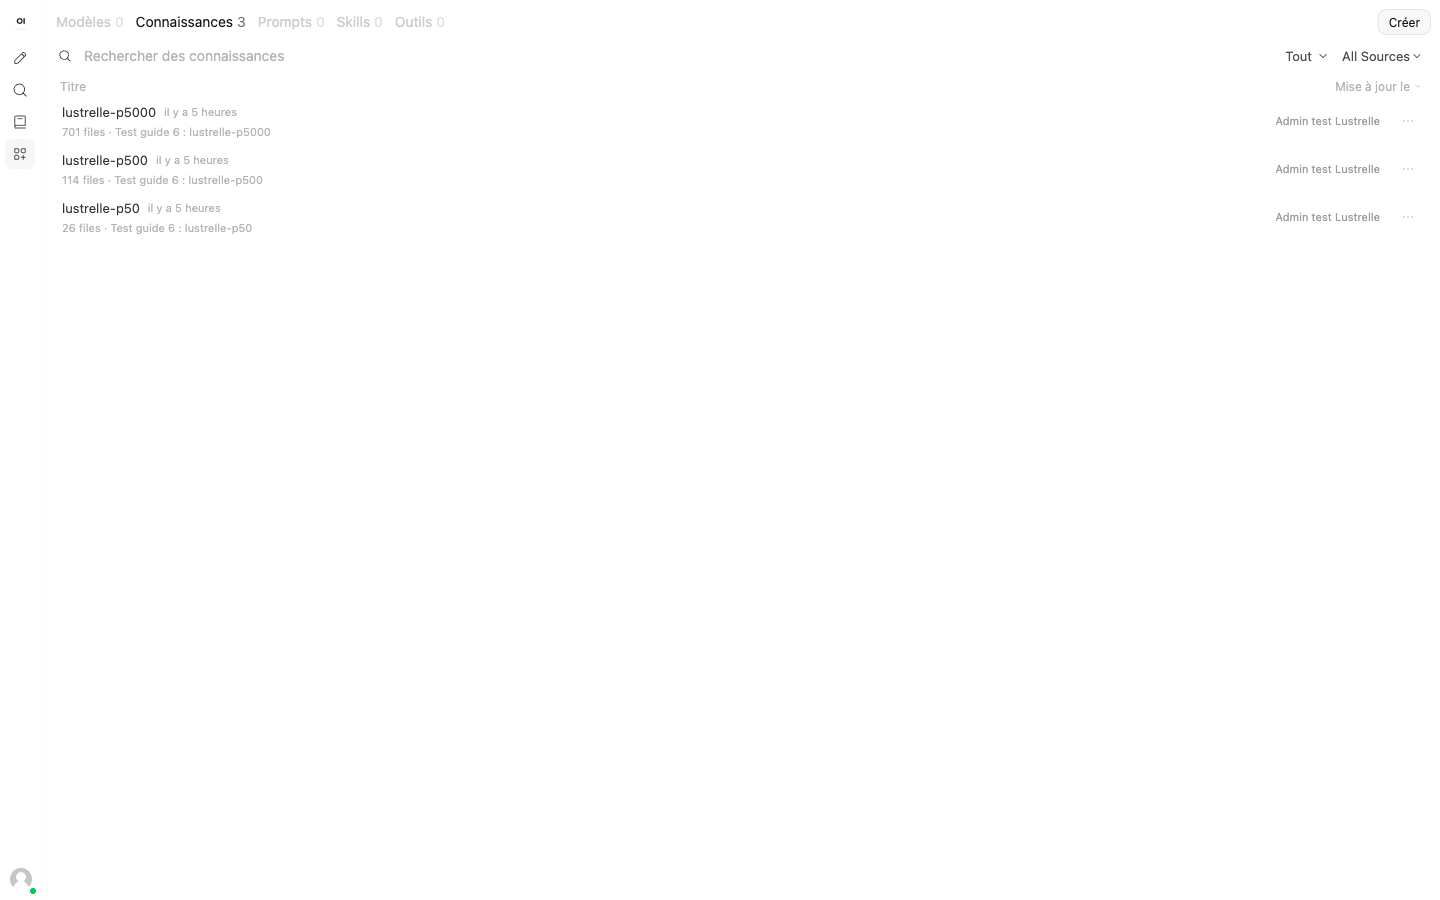
| 500 ページ | 114 | Lustrelle の 60 件の文書と Service-Public の 54 件のシート |
| 5,000 ページ | 701 | Lustrelleの60件のドキュメントとService-Publicの解説ページ641件 |
100 問の質問は言い換えずにそのまま送信しています。そのうち 80 問は文書内に答えがあります:事実に関する質問 50 問、手順 10 問、数値 10 問、総合 10 問です。残りの 20 問は文書内に答えがなく、アシスタントが答えをでっち上げずに、答えがないことを認めるかを確認するためのものです。
- Fait
- 初期消火要員は何人いますか? 想定される回答:十名で、従業員の中から指名されています。
- Chiffre
- スモークドオーク仕上げの 60 cm の Brindille ペンダントライトは税込(TTC)でいくらですか? 想定される回答:360 € TTC(ナチュラルオークで 348 €、スモーク仕上げで 12 € 追加)。
- 文書内に回答がない場合
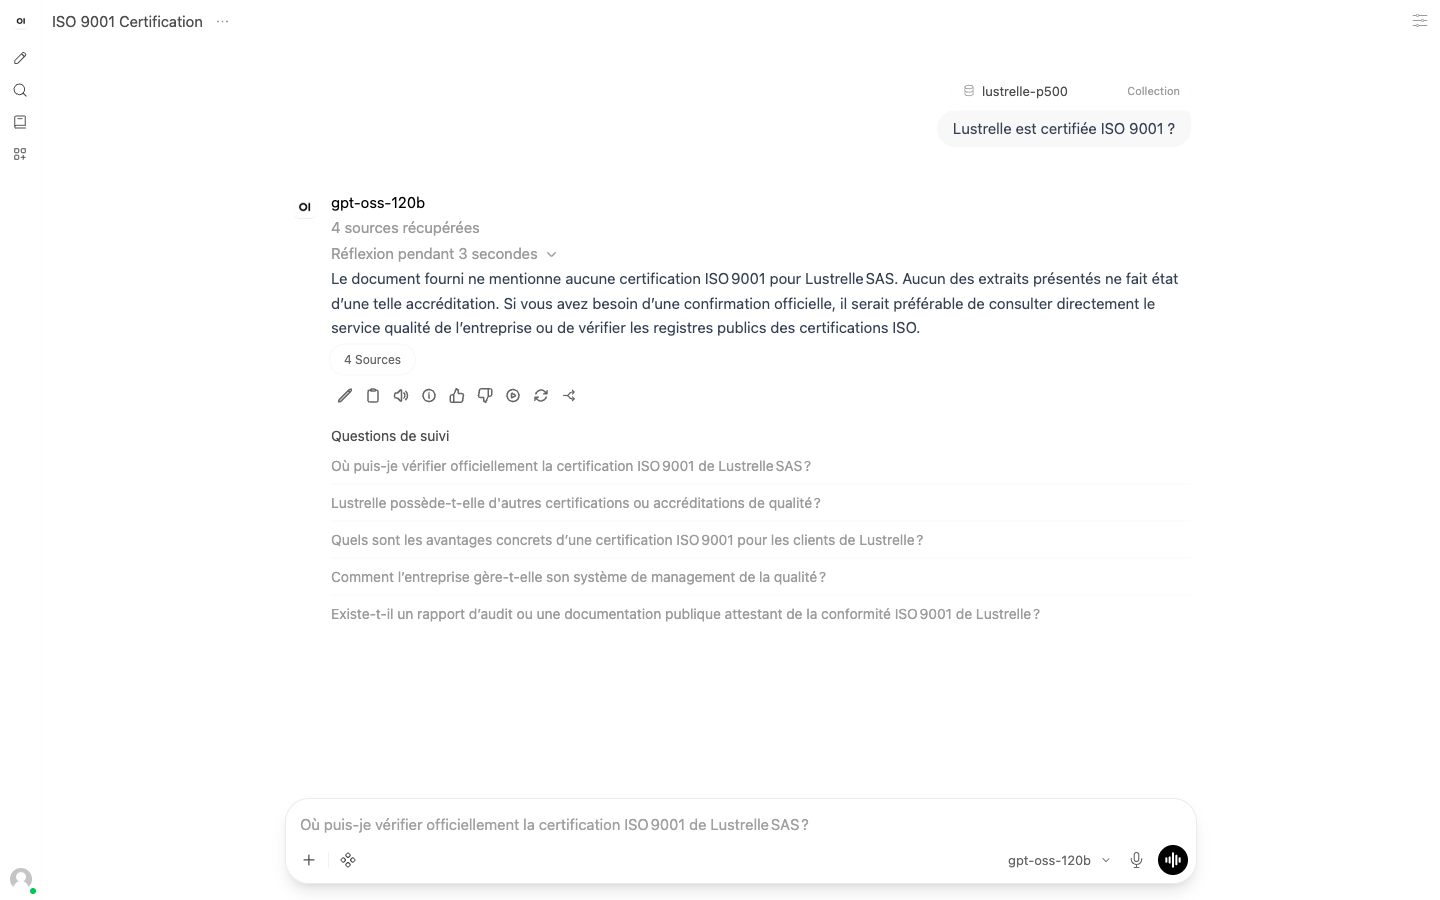
- Lustrelle は ISO 9001 認証を取得していますか? 期待される回答:アシスタントが、文書にはその記載がないと答えること。
#スタックの構築:コマンド
スタックは三つのコンテナと二つの Docker ネットワークで構成されています。最初のネットワークは「内部」ネットワークで、Docker はここから外部へのアクセスを一切許可しません。二つのモデルサーバーは、このネットワークにのみ接続されています。Open WebUI は、モデルと通信するためにこの内部ネットワークに接続されるとともに、ブラウザで画面を開くためのもう一つのネットワークにも接続されています。
以下のコマンドは、2026年10月7日および8日に実施した検証で使用したものです(パスは簡略化しています)。llama.cpp(build 11430)はGB10チップ向けにマシン上でコンパイルしています。コンパイル用のコマンドは、本シリーズの70Bチュートリアルに記載しています。
オプション -np 10 は 10 個のスロットを開きます。これにより十件のリクエストを同時に処理できます(NVIDIA の llama.cpp ガイドではデフォルトで 4 個です)。オプション -c 131072 は全体のコンテキストを設定し、これをスロット間で共有します。RAG_TOP_K を 5 にすると、質問ごとに五つの抜粋を取得します。変数 OFFLINE_MODE、ANONYMIZED_TELEMETRY、DO_NOT_TRACK、SCARF_NO_ANALYTICS は、Open WebUI の更新確認、インターネットからのダウンロード、テレメトリーを無効にします。チャンク分割は Open WebUI のデフォルトのままで、その画面から調整できます。
- 01Open WebUI を開きますhttp://127.0.0.1:3100 にアクセスし、管理者アカウントを作成します。モデルには gpt-oss-120b を選択します。
- 02ナレッジベースを作成します「ナレッジ」セクションを開き、ナレッジベースを作成してファイルを追加します。Open WebUI が各ファイルを読み込み、分割して、埋め込みを計算します。
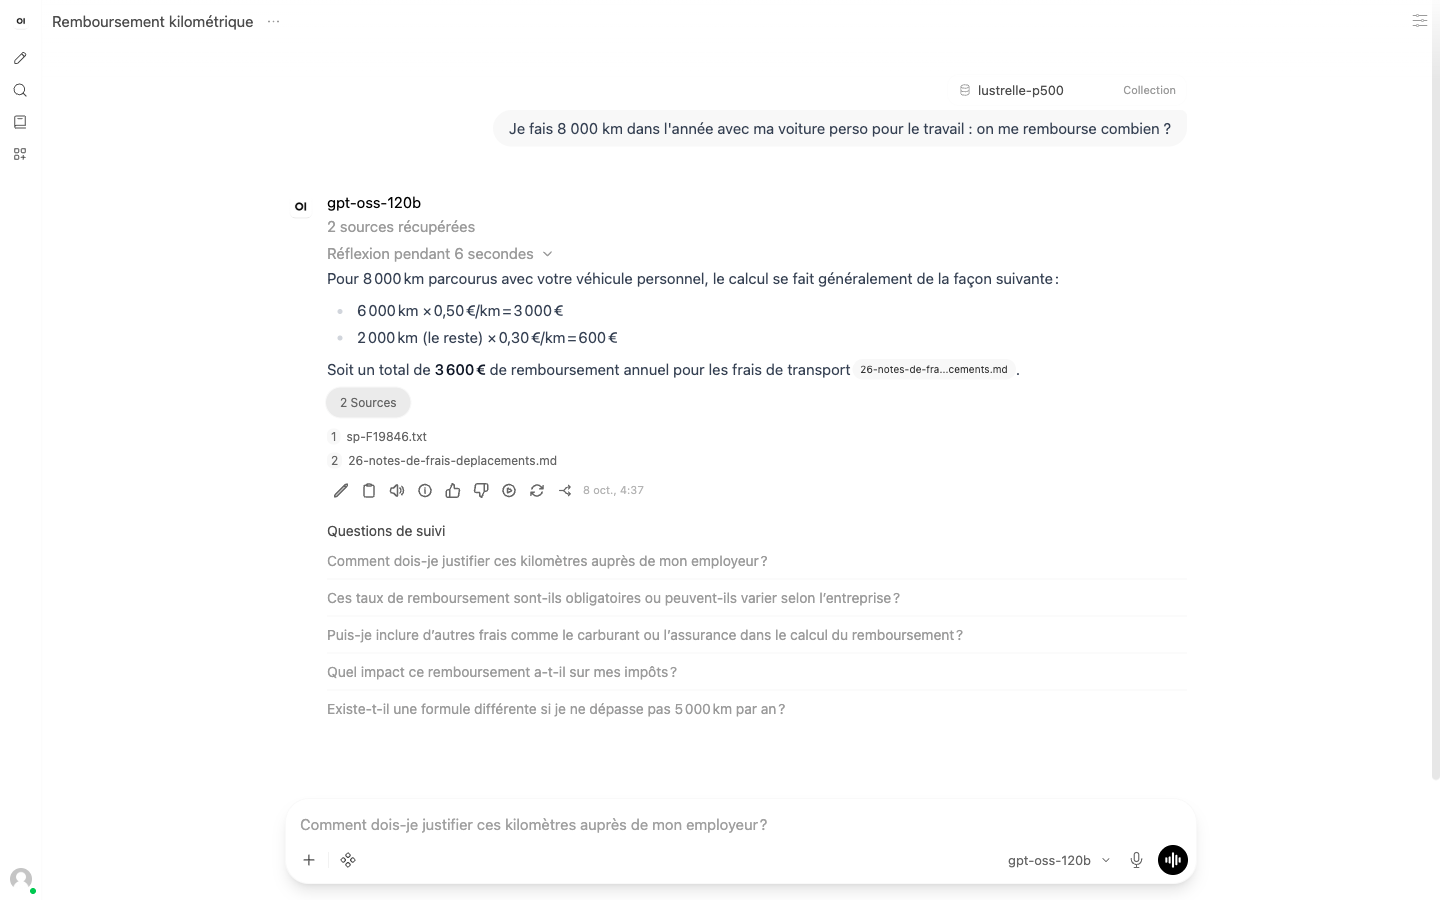
- 03ナレッジベースに質問します会話の中でシャープ記号に続けてナレッジベース名を入力し、質問します。回答は出典とともに表示されます。
測定は Open WebUI の API を通じて行っているため、スクリプトで再現できます。以下は、測定スクリプト(Python で記述)と同じ呼び出しを curl と jq で書き直したものです。
#50ページ、500ページ、5,000ページのインデックス作成
インデックス作成とは、各ファイルを読み込み、チャンクに分割し、bge-m3 で埋め込みを計算して、すべてをデータベースに格納する処理です。スクリプトはファイルを4件ずつ送信し、最後のファイルの処理が終わるまでの時間を計測します。失敗したファイルはありませんでした。
| Base | ファイル | 所要時間 | 失敗 |
|---|---|---|---|
| 50 ページ | 26 | 9,2 s | 0 |
| 500 ページ | 114 | 46,8 s | 0 |
| 5,000 ページ | 701 | 365.9 秒(6.1 分) | 0 |
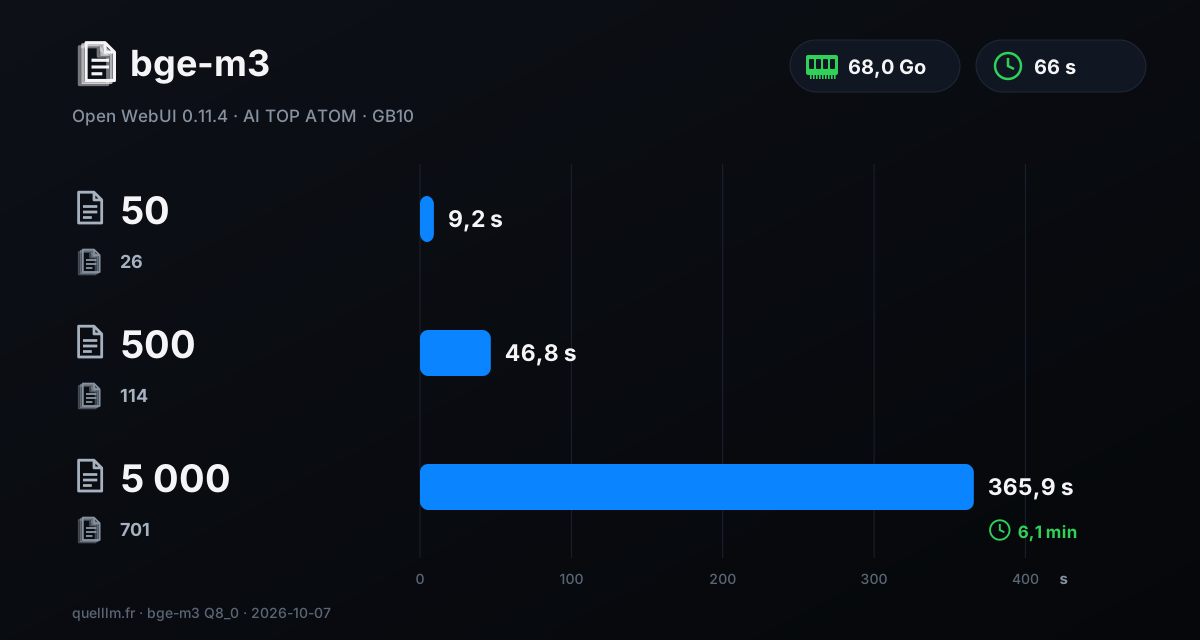
5,000 ページは 6 分強で準備が整います。これは毎秒約 1.9 ファイルに相当します。つまり、5,000 ページの文書群の再インデックスは 7 分未満で完了します。このインデックス作成中、GPU の消費エネルギーは 5.4 Wh でした。
#正しい文書が見つかるか?
回答の品質より前に、アシスタントが正しい場所を検索しているかを知る必要があります。自動指標「正しいドキュメントの検索」は、Open WebUIが返した出典の中に、想定されるドキュメントが少なくとも一つ含まれていた質問の数を数えます。対象は、ドキュメント内に答えがある80問です。この指標はスクリプトで算出しており、品質の評価ではなく、回答が正しいかどうかを示すものでもありません。
| Base | 正しい文書が見つかった | エラーなく受信した回答 | 回答時間の中央値 |
|---|---|---|---|
| 500 ページ | 86 %(80 問中 69 問) | 100 件中 100 件 | 約40秒 |
| 5,000 ページ | 78 %(80 問中 62 問) | 100 件中 100 件 | 約42秒 |
ファイル数が約六倍(701対114)になっても、78%のケースで正しいドキュメントが検索されています。各ナレッジベースの100件の回答は、技術的なエラーも空の回答もなく届き、いずれにも出典の一覧が付いていました。この一覧で検証できます。出典ボタンをクリックすれば、使用されたファイルが表示されます。
#同時に何人まで使えますか?
1 人、5 人、10 人のユーザーが同時にスタックへ問い合わせる状況をシミュレーションしました。ユーザーは、プライベートネットワークである Tailscale を経由する SSH トンネルで ATOM に接続された Mac 上にいます。各ユーザーは 6 つの質問を間を置かずに続けて送信し、回答はストリーミングで返されます。最初の単語が返るまでの時間と完全な回答が返るまでの時間を、中央値で記録しています。各シリーズは 6 件、30 件、60 件のリクエストで構成され、失敗したものはありません。
| ユーザー | Base | 最初の単語 | 回答完了 |
|---|---|---|---|
| 1 | 500 ページ | 9,0 s | 9,6 s |
| 1 | 5,000 ページ | 9,9 s | 10,2 s |
| 5 | 500 ページ | 33,1 s | 38,4 s |
| 5 | 5,000 ページ | 39,3 s | 44,7 s |
| 10 | 500 ページ | 52,4 s | 63,5 s |
| 10 | 5,000 ページ | 50,2 s | 64,8 s |
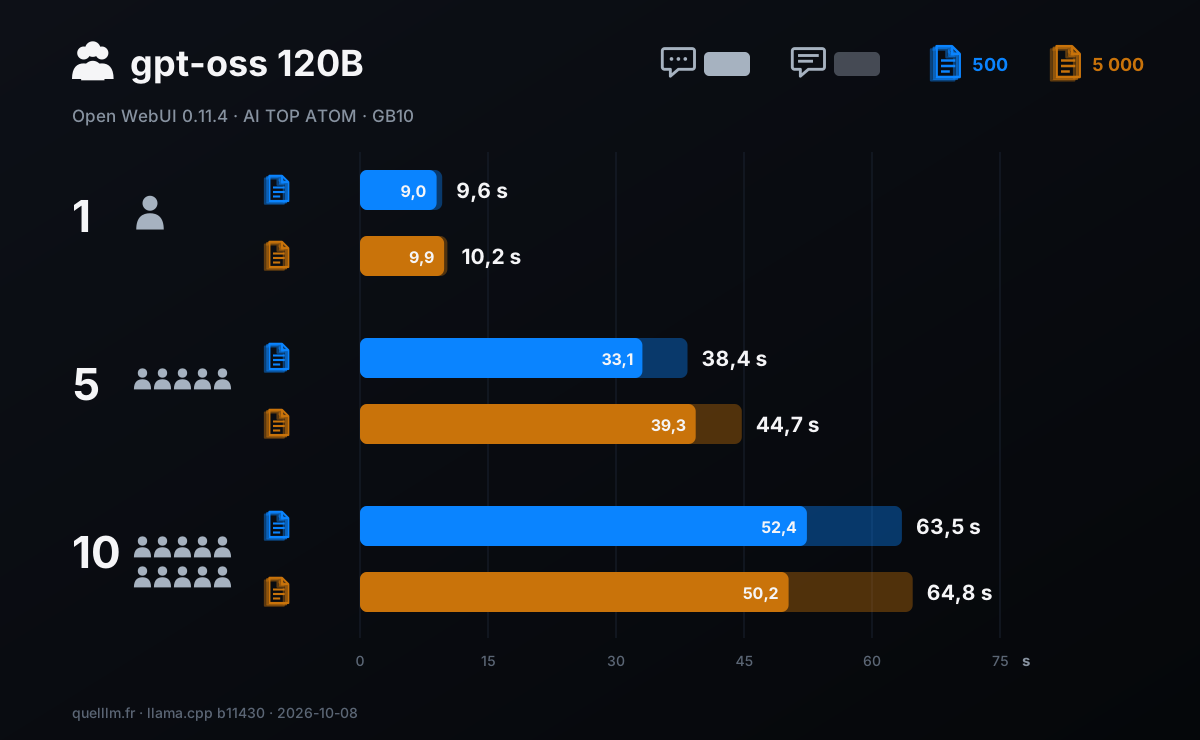
利用者が一人だけの場合、完全な応答が返るまでの時間は500ページで9,6秒、5 000ページで10,2秒です。5人が同時に質問すると、中央値は38秒と45秒に延びます。10人の場合は約一分で、63,5秒と64,8秒です。データベースの規模はこれらの所要時間にあまり影響しません。500ページから5 000ページに増やしても、差は0,6秒から6,4秒の範囲にとどまります。
最初の語は gpt-oss 120B の思考フェーズの後に出力されます。その間、Open WebUI には「6 秒間思考」またはそれに近い時間が表示されます。このフェーズは抜粋の読み込みに加わる時間で、ユーザー間で共有されます。今回のテストは厳しい条件です。各ユーザーは回答を読む時間を取らずに質問を連続して送信していますが、実際の利用者は回答を読んでから次の質問をします。
#5〜20 人向けのサイジング
10人のアクティブユーザーが連続して利用した場合、500ページのナレッジベースでスタックは441秒で60件の回答を完了しました。毎分約8件の回答です。この測定値をもとに計算してみます。20人のチームで、各自が平均5分ごとに一回質問すると、毎分4件の質問が発生し、これはこのスループットの半分にあたります。これは目安であって測定値ではなく、実際の使い方によって異なる場合があります。
- 最大 5 人まで
- 一人が質問した場合は 10 秒で回答、5 人が同時に質問した場合は約 40 秒です。
- 5〜10 人
- 10人が連続して質問した場合、完全な回答まで約一分かかりましたが、エラーは一件もありませんでした。サーバーは10件の並列リクエストを処理するよう設定されています。
- 10〜20人
- 10人を超える同時ユーザーについては測定していません。上記の計算からは、通常の使い方をする20人であれば、測定したスループットの範囲内に収まることが示唆されます。
#機密性:私たちが検証したこと
プライベートアシスタントは、文書が手元にとどまってこそ意味があります。そこで、ネットワークトラフィックを検証しました。各ナレッジベースで 100 件ずつ、計 200 件の回答を生成する間、tcpdump でスタックの二つの Docker ネットワークのパケットをキャプチャし、観測されたすべてのアドレスを一覧にしました。
結果として、スタック内のどのコンテナも外部アドレスへパケットを送信していませんでした。観測されたアドレスは、コンテナとホストマシンのゲートウェイのアドレス、およびマルチキャストアドレスとローカルブロードキャストアドレス(ローカルネットワークの探索メッセージ)のみです。Open WebUI はアクセス用ネットワークに接続されていますが、それでも外部アドレスは一切現れません。二つのモデルサーバーは、Docker が外部から遮断しているネットワーク内にあります。
#エネルギー:応答あたり0,15 Wh
各ナレッジベースで 100 件の回答を生成する間、4 問ずつ同時に質問し、GPU の消費電力を毎秒一回記録しました。500 ページでは、GPU は平均 50.5 W(ピーク 68.1 W)で 18.0 分稼働し、15.2 Wh、つまり 1 回答あたり 0.15 Wh でした。5,000 ページでは 50.7 W、15.4 Wh で、同じく 1 回答あたり 0.15 Wh でした。
| 状況 | 所要時間 | GPU の平均消費電力 | GPU のエネルギー |
|---|---|---|---|
| アイドル状態、タスクなし | 30分 | 10,4 W | — |
| 回答 100 件、500 ページのナレッジベース、同時に 4 件ずつ | 18.0分 | 50,5 W | 15,2 Wh、つまり応答あたり0,15 Wh |
| 100件の回答、5,000ページのデータベース、同時4件 | 18.2 分 | 50,7 W | 15.4 Wh、つまり1回答あたり0.15 Wh |
| 5,000ページのインデックス作成 | 6.1 分 | 53,2 W | 5.4 Wh |
EDF の Tarif Bleu Base 料金(税込 1 kWh あたり 20.01 サンチーム、2026年8月1日適用の料金表、基本料金は含まず)で計算すると、1,000 件の回答は 0.15 kWh、つまり 3 サンチームに相当します。これらの数値は、チップが報告する GPU の消費電力のみを対象としています。NVIDIA によれば、nvidia-smi が表示する電力は GPU 単体のものです。CPU、メモリ、SSD、電源は含まれていません。長期間の消費電力については、本シリーズの別のガイドで詳しく説明しています。
#一件ずつ評価した回答の品質
自動指標では、回答が正しいかどうかはわかりません。そこで、500 ページのナレッジベースで得られた 100 件の回答を一件ずつ評価しました。著者の依頼により、この評価は回答するモデル(gpt-oss 120B)ではなく、Anthropic の AI モデルである Claude が行いました。
各質問について、Claude には想定される回答、出典文書、および下記の評価基準が与えられました。スコアは 0〜2 で、表現ではなく内容(数値、日付、名前、条件)を評価します。ソースが示されていなくてもスコアは変わりません。判断に迷う場合は、低いほうのスコアを採用します。
| Note | ドキュメント内に答えがある質問 | ドキュメント内に答えがない質問 |
|---|---|---|
| 2 | 正確かつ完全:主要な情報が正確で、誤った情報が付け加えられていません。 | アシスタントは、ドキュメント内に情報が見つからないと答え、何もでっち上げません。 |
| 1 | 部分的または不完全:要点は正しいものの、重要な要素が欠けている、または副次的な細部が誤っています。 | 迷ったり的外れな回答をしたりしますが、答えをでっち上げることはありません。 |
| 0 | 誤りまたは捏造:主要な情報が誤っている、ドキュメントと矛盾している、または無関係です。 | 回答をでっち上げる:文書にない数値、日付、名前、規則を答えてしまう。 |
| 質問の種類 | 質問 | スコア | 正確かつ完全 |
|---|---|---|---|
| 統合:複数のドキュメントを突き合わせる | 10 | 95 % | 9 |
| 具体的な事実 | 50 | 80 % | 38 |
| 数値または計算 | 10 | 80 % | 8 |
| 手順:すべてのステップと所要時間 | 10 | 60 % | 3 |
| 文書内に回答がない場合 | 20 | 68 % | 12 |
| Ensemble | 100 | 77 % | 70 |
総合的な質問では、複数の文書を照合し、最新の規則を採用する必要があります。アシスタントはこうした質問に 10 回中 9 回、正確かつ完全に回答しています。誤った回答の大半は、回答の生成ではなく文書の検索に起因しています。
想定される文書がソースに含まれている場合(80 問中 69 問)、57 件の回答が正確かつ完全で、スコアは 88 % に達します。含まれていない場合(11 問)、回答はたいてい誤っています。この検索は Open WebUI の設定(文書のチャンク分割、抜粋の数)に左右されますが、これらは変更していません。お使いの環境では、まずここを調整するのが最初の手段です。
ドキュメントに答えがない20問のうち、アシスタントはそのことを12回明確に伝えています。5件では、ドキュメントに由来しない情報を付け加えています。数値による推定、二つの概念の混同、あるいは誤って割り当てられた番号です。回答の下に表示される出典を開くと、こうしたケースを見つけられます。
各評価は、その根拠、質問、想定される回答とともに、データページのCSVファイルで公開しています。5,000ページのナレッジベースでの100件の回答は評価しておらず、「正しいドキュメントの検索」指標のみを適用しています。
#ATOMが適している人
- 自社の文書を扱うアシスタントを求める、従業員5〜20人の中小企業
- すべてが一台のマシンに収まります。メモリ68 GB、起動66秒、5,000ページのインデックス作成に6分、一人が質問した場合の回答は10秒です。
- 機密文書を扱う事務所や部署
- 200件の回答の間、外部へ送信されたパケットは一つもありませんでした。私たちの構成では、ドキュメントはマシン上にとどまります。
- アシスタントを共有したいチーム
- 継続的に利用する 10 人のアクティブユーザー全員が、約一分で、エラーなく回答を受け取りました。
- インテグレーターまたは IT 部門
- このスタックは、Docker、Open WebUI、llama.cpp、オープンウェイトのモデルといったオープンな構成要素で成り立っています。プロプライエタリなのは、ドライバー、CUDA、NVIDIA のコンテナだけです。Open WebUI には、お使いのソフトウェアから呼び出せる API も用意されています。
プラットフォームとメーカーを分けて考えましょう。この結果を可能にしているのは NVIDIA GB10 チップです。128 GB のユニファイドメモリに、1,170 億パラメータのモデル(gpt-oss 120B)とそのコンテキスト、さらに埋め込みモデルを収容でき、メモリ帯域幅は公称 273 GB/s です。
GIGABYTE は、容量一リットル(1.2 kg)の独自筐体と二基のファンによる冷却機構を採用しています。5,000ページを対象とした100件の回答の間、GPU の温度は平均66 °C、最高でも72 °C にとどまり、スロットリングは一度も報告されませんでした。
2026年10月8日に確認したATAGB10-9001(128 GB、PCIe 4.0接続の4 TB SSD)の価格:AORUS公式ストアでは税込6,346.27 €で、在庫切れでした。Amazon.frでは在庫がありました。私たちが測定したのは、SSDがPCIe 5.0接続のATAGB10-9000です。GB10の価格は毎週変動するため、購入前にご確認ください。
#測定していないこと
- 人間による採点
- 回答の採点は、人ではなく AI モデルの Claude が行いました。5,000ページのデータベースは採点していません。各評価は検証できるよう、その根拠とともに公開しています。
- 実際のドキュメント
- 使用したコーパスは架空のもので、フランス語で書かれた Markdown 形式とテキスト形式の文書です。PDF、Word 文書、スキャン画像、表は測定の対象外です。
- 10人を超えるユーザー
- サーバーは10件の並列リクエストを処理するよう設定されています。それを超える数や、別々のアカウントでの測定は行っていません。使用したテスト用アカウントは一つだけです。
- その他の設定
- チャンク分割(Open WebUI のデフォルト設定)と抜粋の数(5 に固定)は変更していません。他の設定にすると、正しい文書が見つかる割合が変わる可能性があります。
- エネルギー
- GPU 単体のみが対象です。
更新と訂正:2026年10月8日に回答の評価を追加しました。今後の訂正にはすべて日付を記載します。
#FAQ
アシスタントは同時に何人まで利用できますか?+
文書がマシンの外に出ることはありますか?+
何ページまでインデックス化でき、どのくらいの時間がかかりますか?+
ATOM の 128 GB 版は必要ですか?+
アシスタントの回答はどのように確認すればよいですか?+
1 回答あたりの電気代はいくらですか?+
ご意見、誤りのご指摘、補足はありますか?ぜひお知らせください。皆さんにとってより良いガイドにするために役立ちます。