GIGABYTE AI TOP ATOM:GB10 128 GBを詳細に測定
GIGABYTEのAIミニPC:NVIDIA GB10チップと128 GBのユニファイドメモリを一リットルの筐体に搭載。LLMを動かすうえで重要な点を見ていきます ローカルで :メモリ、帯域幅、速度、価格、そしてどんな人にとって購入に適しているのか、あるいは適していないのか。
09/10/2026 に更新
購入先
ボタンで案内している構成は、購入時に提示されるものです。ミニPCでは、システム用のメモリを残し、推論エンジンを確認してください。macOS/MLXとCUDAは相互に置き換えて使うことはできません。
アフィリエイトリンク — リンク経由で購入すると、QuelLLM が紹介料を受け取る場合があります。購入者に追加費用はかかりません。また、紹介料の有無は、独立した立場で選定したこれらのおすすめには影響しません。Amazon アソシエイトとして、QuelLLM は条件を満たす購入から利益を得ています。
技術仕様
- メモリ統合128 GB(LPDDR5x)、システムから認識される容量121,7 GB
- 帯域幅273 GB/s
- 計算Blackwell GPUと20個のArmコア。NVIDIA によれば、スパース性を利用したFP4で最大1 PFLOP(発表値であり、当社では未測定)
- 消費電力240 WのUSB-Cアダプター;当社の測定では、アイドル時のGPUは10.4 W、負荷時の平均は39~53 W(GPU単体、ワットメーターなし)
- 参考価格6 346,27 €(ATAGB10-9001、4 TB PCIe 4.0、AORUS公式ストアでは売り切れ、Amazon.frでは在庫あり)・7 999,95 €(ATAGB10-9000、4 TB PCIe 5.0、LDLCおよびMateriel.netでは在庫切れ)—2026年10月8日時点
- 最大のモデル3ビットのQwen3-235B-A22B(90.5 GB使用、21 GBの余裕) · 毎秒約5トークンのLlama 3.3 70B、小型の粗いモデルなら2.6~4倍高速 · 毎秒58トークンのgpt-oss 120B;4Bから235Bまでの13モデルは、コンテキスト32 768トークンで収まります
どのような方に向いていますか?
メリットと限界
✓ 強み
- 128 GBのユニファイドメモリ:4Bから235Bまでの13モデル(3ビット)が、32 768トークンのコンテキストとともに収まります
- NVIDIAのDGX Sparkの速度:llama.cppでは最大4.3%、Ollamaでは最大2%の誤差
- 連続負荷時も安定した速度:16ユーザーで1時間あたりの変動0,0 %、8ユーザーで2時間あたり−0,6 %、スロットリングの報告なし
- ATAGB10-9000の4 TB PCIe 5.0 SSD:読み取り速度13 GB/s
- CUDAの完全なスタック:llama.cpp、vLLM、TensorRT-LLM、Unslothはすべて当社環境で動作しました
- 一リットルの筐体、1,2 kg、すっきりとしたフロントパネル
✗ 限界
- 128 GBのRyzen AI Max+ 395ミニPCより高価格
- 70Bの密モデルは毎秒約5 tokensで書き込みます。これはGB10プラットフォームの帯域幅(273 GB/s)の限界です。MoEモデルまたは小さなドラフトモデル(×2,6~×4)なら、会話速度が向上します
測定した内容
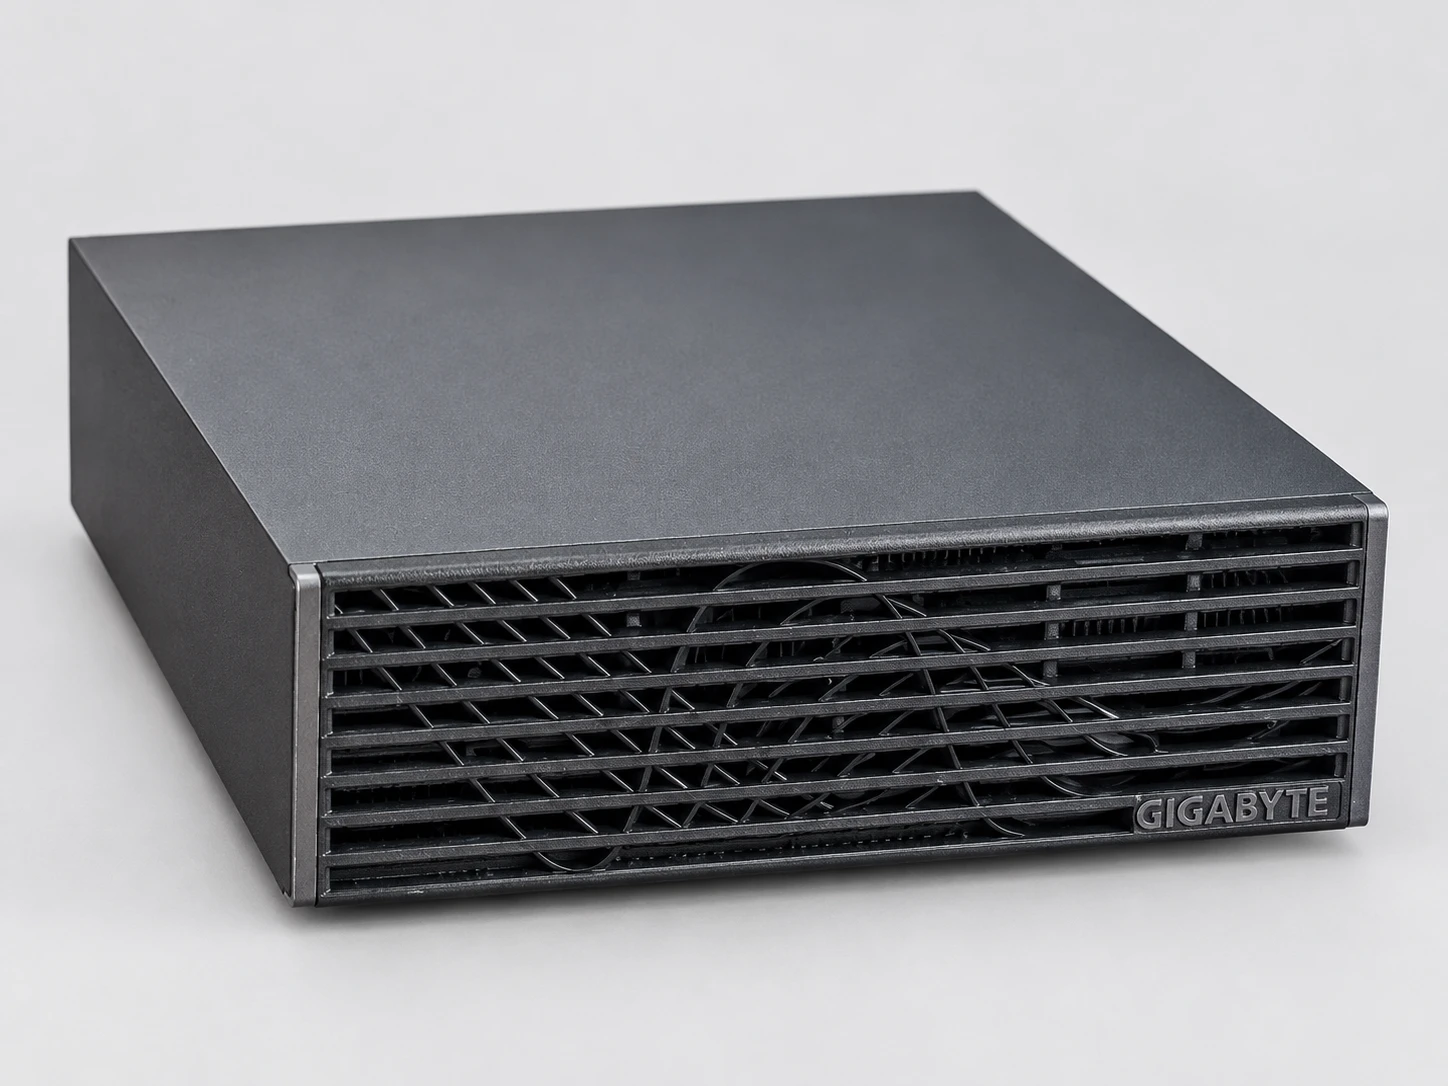
GIGABYTEは、ガイドシリーズ用としてAI TOP ATOM(ATAGB10-9000:128 GB、4 TB PCIe 5.0 SSD)を無償で提供しました。測定結果と見解は当社のものであり、GIGABYTEは公開前にこの内容を確認も承認もしていません。手法(初回測定前に固定したプロトコル)、モデルファイルのフィンガープリント、当社の表のデータは、当社の 方法論のページ。当社のデータ、インフォグラフィック、写真は、ライセンスのもとで再利用できます CC BY 4.0、quelllm.frを引用しながら。
| Guide | これが示すもの |
|---|---|
| 実際に動作するLLMはどれか | 4Bから235Bまでの13モデル:すべてコンテキスト32 768トークンで収まります;gpt-oss 120Bは毎秒58トークン |
このシリーズは週1本公開の全7ガイドで構成され、新しいガイドが公開されるたびにこのページが更新されます。
AI TOP ATOMの各モデル
GIGABYTEはATOMをATAGB10-9000からATAGB10-9005まで6つの型番で展開しています。最初の3機種は128 GBです。9000はPCIe 5.0接続の4 TB SSD(当社が測定した機種)、9001はPCIe 4.0接続の4 TB、9002はPCIe 4.0接続の1 TBです。64 GB版は2026年10月23日から発売予定です。販売店で正確な型番を確認してください。一部の仕様表ではSSDの説明が誤っています。
対象者
- 5~20人のチーム ドキュメント上でプライベートなAIアシスタントを使いたい方(同時利用者10人まで測定)。
- CUDA開発者 デスク上でNVIDIAの完全なスタックを使いたい方。
- ローカルでのファインチューニング :Qwen3-8BのLoRA、70BのQLoRA、およびUnslothを使用したgpt-oss 120B。
- 大規模MoEモデル 1,000億を超えるパラメーターを、快適な速度で。
判定
よくある質問
GIGABYTE AI TOP ATOMは70BのLLMをローカルで実行できるのでしょうか?
3ビットのQwen3-235B-A22B(使用量90,5 GB、余裕21 GB)・Llama 3.3 70Bは毎秒約5トークン、小型のドラフトモデルを使えば2,6~4倍高速・gpt-oss 120Bは毎秒58トークン。4Bから235Bまでの13モデルは、32 768トークンのコンテキストで収まります。
GIGABYTE AI TOP ATOMの価格はいくらですか?
6 346,27 €(ATAGB10-9001、4 TB PCIe 4.0、AORUS公式ストアでは売り切れ、Amazon.frでは在庫あり)・7 999,95 €(ATAGB10-9000、4 TB PCIe 5.0、LDLCおよびMateriel.netでは在庫切れ)を基準とします—2026年10月8日時点(NVIDIAが米国で4 999 $から提供する64 GB版を発表、2026年10月23日から利用可能;GIGABYTEは2026年10月5日にAI TOP ATOM 64 GBを確認済み)。価格はすぐに変わるため、購入リンクで当日の価格を確認してください。
GIGABYTE AI TOP ATOMはどのような人に向いていますか?
CUDA開発者、プライベートAIアシスタントを求めるチーム、ローカルでのファインチューニング、100Bを超える大規模MoEモデル。