GB10 128 GB:実際に動作するLLMはどれか (mesures)
GIGABYTE AI TOP ATOM(NVIDIA GB10、128 GB)では、4Bから235Bまで測定した13モデルが、32 768トークンのコンテキストと少なくとも20 GBの余裕を確保して動作します。各トークンでパラメーターの一部しか有効にしない大型MoEモデルは、同じサイズの密なモデルよりはるかに高速です。gpt-oss 120Bは毎秒58トークンを出力します。70Bの密なモデルは毎秒4,8トークンです。速度を決めるのは容量ではなく、メモリ帯域幅です。
百二十八ギガバイトの統合メモリ。それが、GB10 マシンがグラフィックカードに対して持つ強みです。しかし、実際には何を、どの程度の余裕を残して、どの速度で読み込めるのでしょうか。GIGABYTE から無償提供された AI TOP ATOM で、4B から 235B までの 13 モデルを、最初の測定前に固定した手順で測定しました。何が収まり、日常的に何が快適で、誰にとって適した買い物なのかを紹介します。
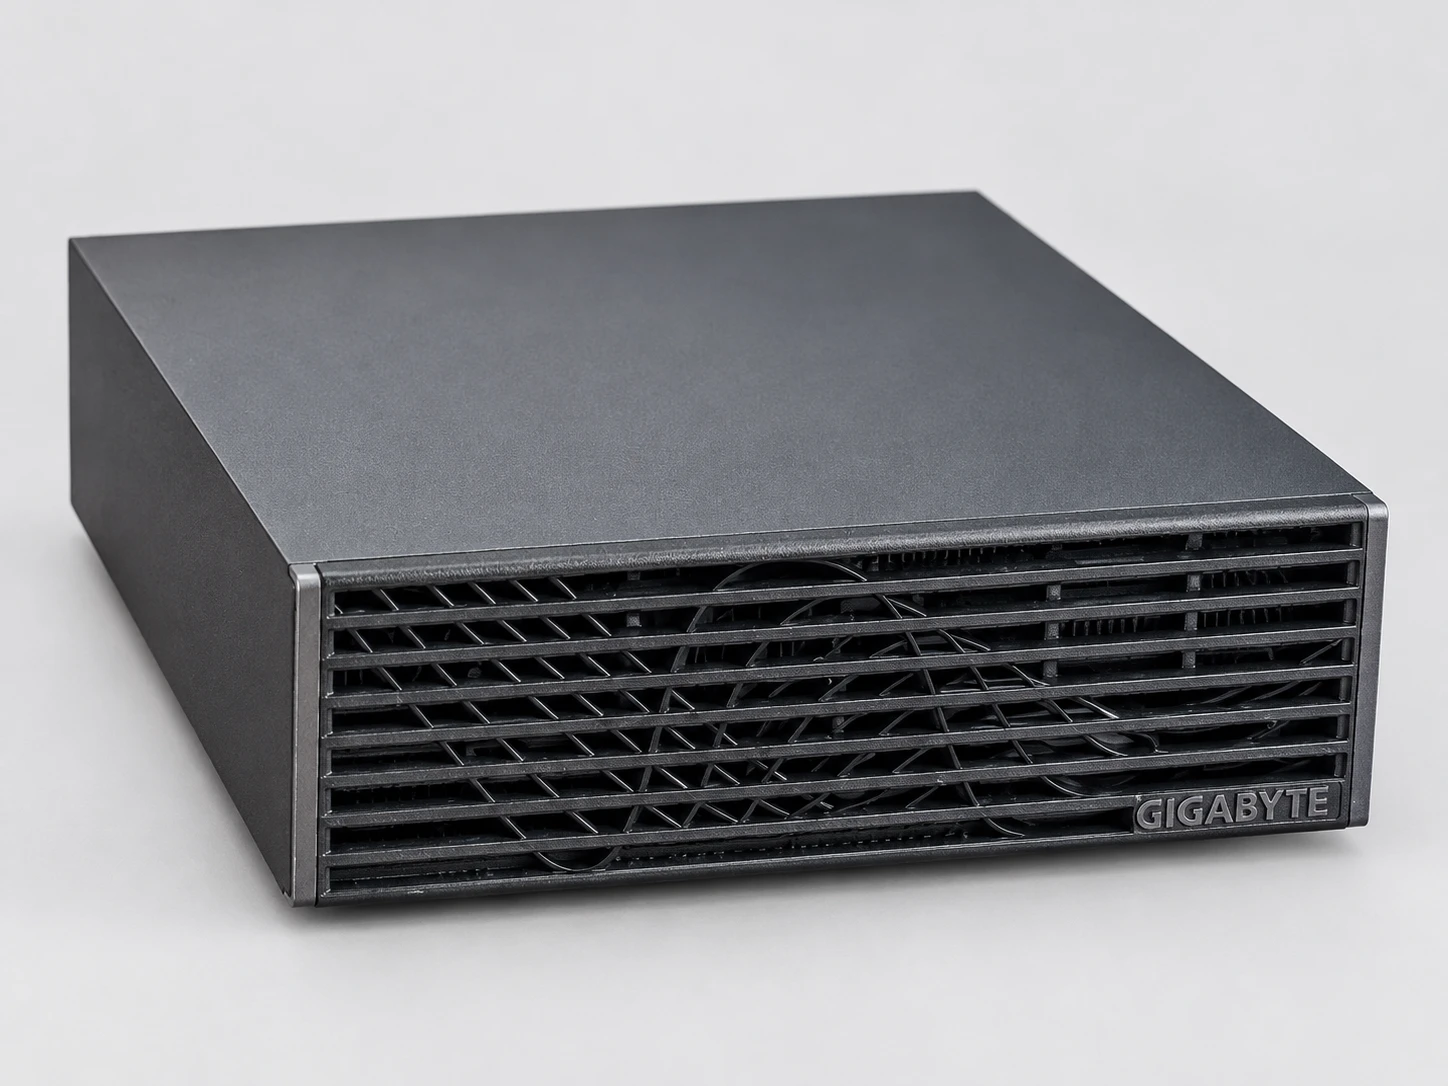
#テストしたマシン
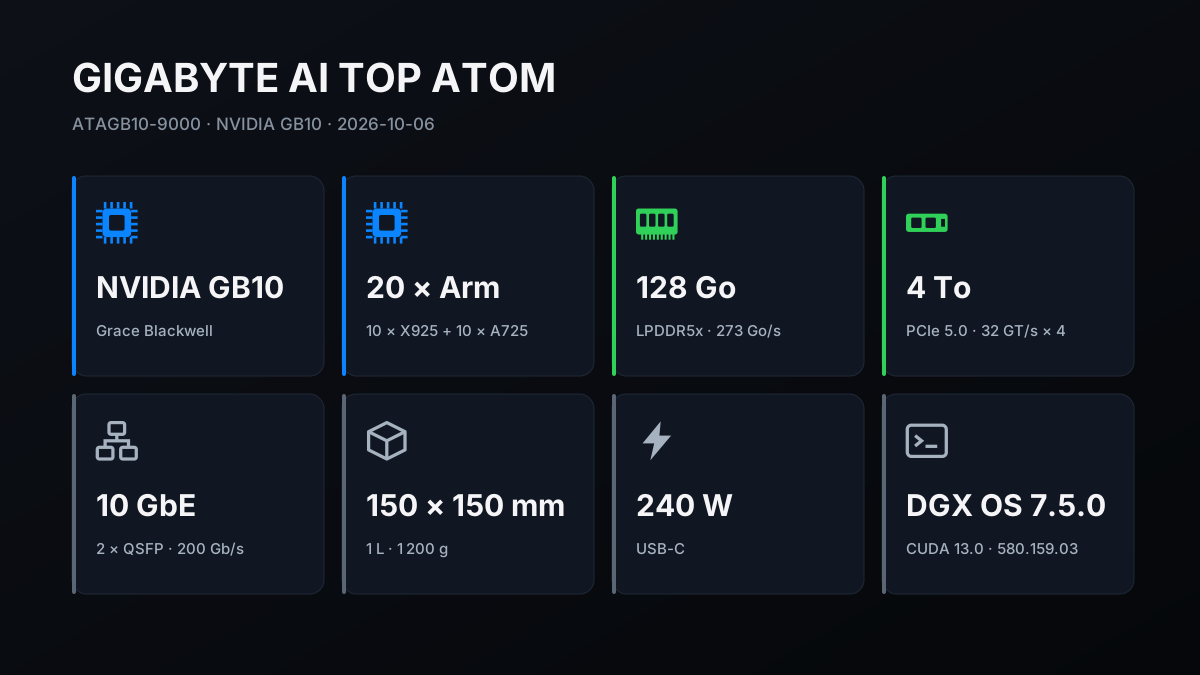
マシンは GIGABYTE AI TOP ATOM、型番 ATAGB10-9000 です。NVIDIA GB10 チップ(Arm コア 20 個と、公称 273 GB/s の 128 GB メモリを共有する Blackwell GPU)、PCIe 5.0 接続の 4 TB SSD を搭載しています。DGX OS 7.5.0 で動作し、これは Ubuntu ベースの NVIDIA システムです(ドライバー 580.159.03、CUDA 13.0)。
使用したソフトウェアは三つです。ローカルでモデルを実行するための、広く使われているオープンソースエンジンllama.cppを現地でGB10向けにコンパイルし、主要な表を作成しました。Ollama 0.34.1は、同じバージョンで測定したMacBook Pro M5 Maxとの比較に使用しています。複数の人に同時に応答するために設計されたサーバーvLLM 26.09は、NVIDIAが提供するコンテナ内で動作します。
#測定方法
llama.cppの速度は五回の反復から得たもので、標準偏差(反復間のばらつき)は最大3 %です。ロード時間、30 000トークンの文書の読み込み、メモリの余裕は一回だけの測定です。複数ユーザーでのテストは三回繰り返しています。最初の測定前には、三分間のテストを行い、GPUが計算性能を維持できることを確認しました。
13個のモデルのファイルにはSHA-256フィンガープリント(ファイルのデジタル署名)があり、これらのモデルをホストしているサイト、Hugging Faceが公開したものと一致しています。プロトコルは10月5日に作成され、最初の測定前の6日13時30分に固定されました。
同日16時50分頃の追補により、コールド状態での再測定が夜に前倒しされ、ここで取り上げるテストが追加されました:Ollamaの公式スクリプト、投機的デコーディング、連続負荷、そしてNVFP4でのLlama 3.3 70Bです。手法、ファイルのハッシュ、表のデータは、手法のページで公開しています。
主要な数値は、20分休ませてキャッシュを消去した同じ日の夜に再測定しました。差は最大2,6 %で、プロトコルのしきい値である3 %未満でした。
#DGX Sparkとほぼ同じ速度(数パーセントの差)
私たちの知る限り、128 GBのGB10マシンは同じNVIDIAチップと同じメモリを共有しています。構造、冷却、ストレージは異なる場合があります。ATOMの位置づけを確認するため、NVIDIAのDGX Spark向けに公開された二つの基準値を、同じソフトウェアバージョンと同じ設定で再測定しました。
llama.cpp(ビルド7941。プロジェクトが公開した表で使用されているもの。なお、当社のメイン表ではより新しいビルド11430を使用)では、共通する六つのモデルについて、読み取りは2,3 %以内の差で同一です。書き込みは中央値で2,8 %、最大で4,3 %低くなります。Ollama の公式スクリプト(公開測定で使用されたバージョン0.12.6)では、読み取り・書き込みともに、当社の三つの測定値は2 %以内の差でした。gpt-oss 20B、gpt-oss 120B、Llama 3.1 70B です。
したがって、このガイドの速度は、数パーセント程度の誤差で、128 GB のほかの GB10 マシンにも当てはまるはずです。測定したのは ATOM だけです。その構造と負荷時の挙動(温度、1 時間および 2 時間の安定性)はシリーズ次回のガイドで詳しく説明し、消費電力については専用ガイドで扱います。
#4Bから235Bまでの13モデル:使用容量と速度
表はキャンペーンの概要をまとめたものです。「使用メモリ」は、32 768トークンのコンテキストを予約してモデルを読み込んだ後に減少する、利用可能メモリの量です。「読み込み」は、ディスクキャッシュを消去したコールドロードの所要時間です。速度は、計測ツールllama-bench(llama.cpp、2026年10月5日のbuild 11430)で、空のコンテキストの場合と、32 768トークンがすでに存在する場合について測定しています。長いドキュメントでの実際の所要時間は、後述します。
| モデル | 種類 | 使用メモリ | Chargement | 書き込み(空 → 32k) | 読み込み(空 → 32k) | 用途 |
|---|---|---|---|---|---|---|
| Gemma 3 4B(Q4_0) | dense | 4.6 GB | 3 s | 80,8 → 63,6 | 6 239 → 5 409 | 非常にスムーズ |
| Qwen2.5-Coder 7B(Q8_0) | dense | 10.2 GB | 3 s | 30,0 → 23,3 | 3 746 → 2 138 | fluide |
| gpt-oss 20B (MXFP4) | MoE、アクティブ3,6 Md | 13.0 GB | 4 s | 81,4 → 62,5 | 4 950 → 3 316 | 非常にスムーズ |
| Qwen3.8 27B (Q4_K_XL) | dense | 19,1 GB | 5 s | 11,8 → 10,6 | 865 → 717 | correct |
| Qwen3.6 35B-A3B (Q4_K_XL) | MoE、アクティブ3 Md | 22,4 GB | 5 s | 66,0 → 55,6 | 2 987 → 2 429 | 非常にスムーズ |
| GLM-4.7-Flash (Q8_0) | MoE、アクティブ3 Md | 32,6 GB | 6 s | 51,4 → 35,5 | 2 392 → 608 | 非常にスムーズ |
| Qwen3-Coder 30B-A3B (Q8_0) | MoE、アクティブ3,3 Md | 34,3 GB | 6 s | 62,6 → 33,2 | 3 377 → 1 603 | 非常にスムーズ |
| Llama 3.3 70B (Q4_K_M) | dense | 51,1 GB | 8 s | 4,8 → 3,9 | 405 → 269 | バッチ処理に最適 |
| gpt-oss 120B(MXFP4) | MoE、アクティブなパラメーターは5,1 Md | 61,7 GB | 10 s | 58,0 → 42,2 | 2 609 → 1 832 | 非常にスムーズ |
| Qwen3.5 122B-A10B(Q4_K_XL) | MoE、アクティブ10 Md | 74,5 GB | 12 s | 23,1 → 21,4 | 1 126 → 945 | fluide |
| Nemotron-3 Super 120B-A12B (Q4_K_XL) | MoE、アクティブ12 Md | 80,4 GB | 12 s | 16,9 → 16,5 | 851 → 809 | correct |
| Qwen3.8-Flash-Next 125B(IQ4_XS) | MoE、アクティブなパラメーターは約6 Md | 89,5 GB | 21 s | 27,3 → 25,2 | 1 073 → 917 | fluide |
| Qwen3-235B-A22B(Q2_K_XL) | MoE、アクティブ22 Md | 90,5 GB | 12 s | 17,7 → 11,8 | 588 → 331 | 十分;強い圧縮(Q2) |
表の読み方:密なモデルは各トークンで全パラメーターを使い、MoE(「mixture of experts」)モデルはその一部だけを使います。使用されるパラメーター数は十億単位(Md)で示しています。括弧内の記号は重みの圧縮方式を表します。私たちのファイルでは、Q8はパラメーターあたり8,5ビット、Q4とMXFP4は4,3~5,6ビット、Q2_K_XLは3ビットを占めます。これは表の中で最も強い圧縮です。
「Usage」列では、空のコンテキストでの生成速度に対する私たちの目安を適用しています。毎秒40トークンを超えると非常に滑らか、20~40なら滑らか、10~20なら十分です。それ未満の場合、モデルはバッチ処理用に限定しています。
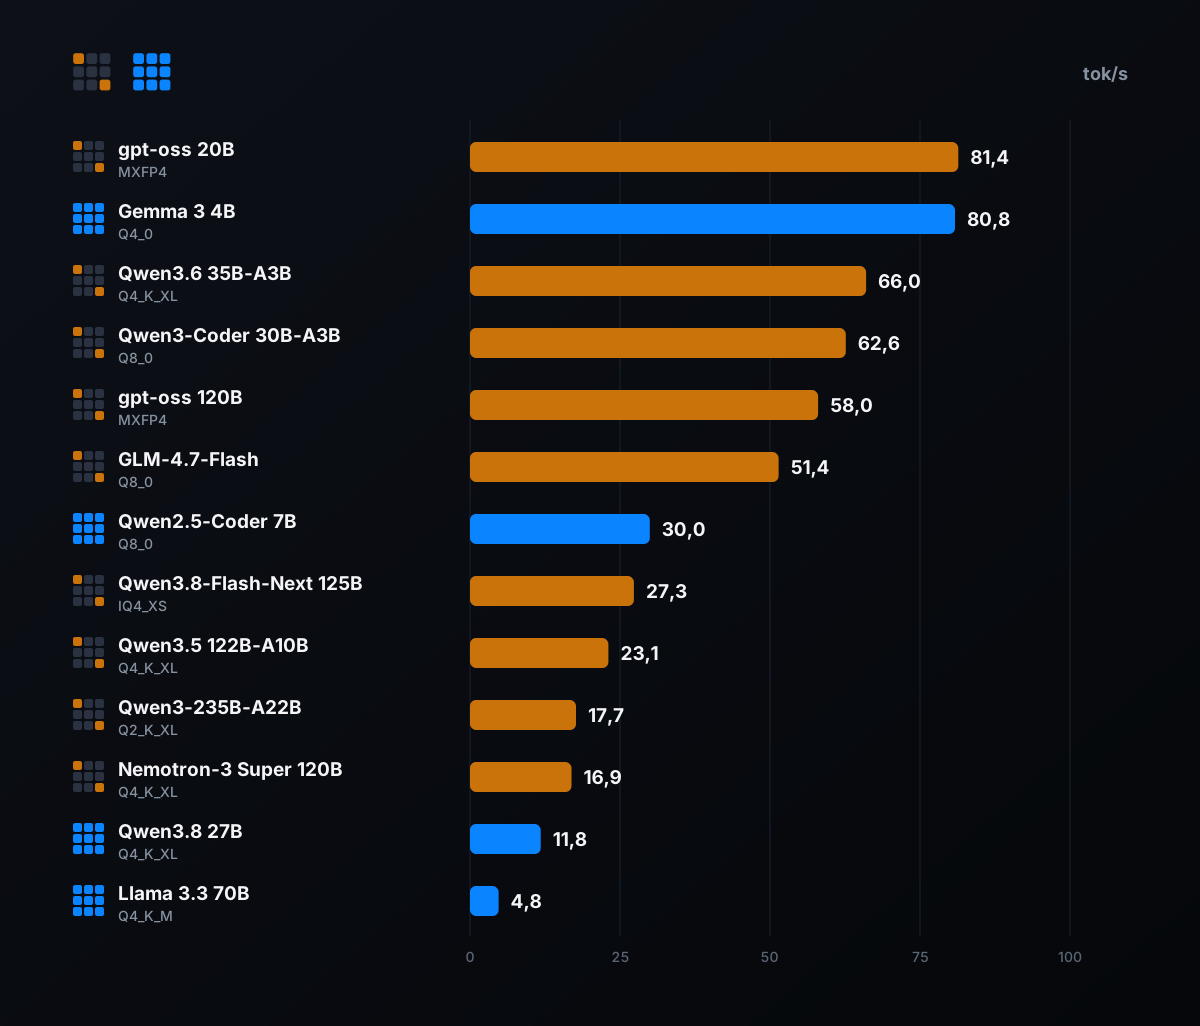
第一の教訓:この表のどの項目もマシンを困難な状態にはしません。コンテキスト30,000トークンでも、Qwen3-235Bには21 GBの空きが残ります。より選択に役立つ第二の教訓は、容量が制約になることはほとんどないということです。速度を決めるのはモデルの選択で、毎秒4.8トークンから81.4トークンまで変わります。
#速度を決めるのはサイズではなくアクティブパラメータ
各トークンを書き込むには、チップがそのトークンに使う重みをメモリから読み直す必要があります。帯域幅が273 GB/sなら、最大速度は単純に計算できます。273を、各トークンで読み込む重みの量で割ります。密モデルは毎回すべての重みを読み込みますが、MoEモデルはそのトークン用に選ばれた「エキスパート」の一部だけを読み込みます。
これが表の逆説を説明します。gpt-oss 120Bのファイルサイズは59 GBですが、モデルがトークンごとに有効化するパラメーターは5,1 milliards בלבדで、毎秒58,0トークンを書き出します。ファイルサイズが16 GBで三倍以上軽いQwen3.8 27Bは高密度モデルです。各トークンで27 milliardsのパラメーターをすべて有効化し、毎秒11,8トークンを書き出します。大きいモデルは小さいモデルのほぼ五倍の速度です。
| モデル | アクティブなパラメータ | 理論上の上限 | 測定済み | 上限に対する割合 |
|---|---|---|---|---|
| Qwen2.5-Coder 7B(dense) | 7,6 Md | 33,7 | 30,0 | 89 % |
| Llama 3.3 70B(密モデル) | 70,6 Md | 6,4 | 4,8 | 74 % |
| Qwen3.8 27B(dense) | 27,3 Md | 15,6 | 11,8 | 76 % |
| Qwen3-Coder 30B-A3B (MoE) | 3,3 Md | 77,8 | 62,6 | 81 % |
| gpt-oss 120B (MoE) | 5.1 Md | 98,7 | 58,0 | 59 % |
| Qwen3.6 35B-A3B(MoE) | 3 Md | 141,1 | 66,0 | 47 % |
この表では、アクティブなパラメーター数が公開されているか、llama.cppで確認できる6モデルを取り上げています。密モデルはこの上限の74~89 %に達し、GB10はメモリのほぼすべてを活用します。
十三モデル全体では、Qwen3.8-Flash-Nextを除く八つのMoEが47~81%に達し、そのうち六つは52~62%です。エキスパートの選択と付随する計算によって、各トークンに固定時間が加わる可能性があります。Qwen3.8-Flash-Nextはこの計算に含めていません。1250億個に加えて、参照テーブル用のパラメーター510億個を数えるため、推定に適していないからです。
同程度のサイズで比べると、MoEはそれでもはるかに高速です。そこで、これが主な助言になります。GB10マシンで大規模モデルを使うなら、MoEを優先してください。Gemma 3 4Bのような小型の密モデルも非常に高速に書き出します(毎秒80,8トークン)が、はるかに小さく、用途も異なります。
#1,000億パラメータを超えるモデル
これが128 GBの存在理由です。NVIDIAはこのプラットフォームで最大2000億パラメーターのモデルに対応すると発表しています。私たちの測定結果もこの公約を裏付けており、3ビットに圧縮した235Bモデルならさらに余裕をもって収まります。1000億パラメーターを超えるモデル5つがATOMに収まり、いずれもコンテキスト30 000トークン時に少なくとも20 GBの余裕があります。
- gpt-oss 120B、速度と容量の最良のバランス
- 毎秒58.0トークン、コンテキストを含めて61.7 GBを使用し、10秒でロードされます。OpenAIはこれをMXFP4形式で直接公開しており、追加の圧縮なしで収まります。
- Qwen3.8-Flash-Next 125B、巨大なQwenの中で最速
- アクティブなパラメーター約60億個で毎秒27,3トークン、IQ4_XSで89,5 GBを使用します。より圧縮率の低いQ4_K_XL版も、余裕はわずかですが収まります(詳しくは後述)。
- Qwen3.5 122B-A10B
- 毎秒23,1トークン、74,5 GB。アクティブなパラメータ百億個により、gpt-ossの後塵を拝します。
- Nemotron-3 Super 120B-A12B(NVIDIA)
- 毎秒16,9トークン、80,4 GB。アクティブなパラメータ十二億個により、gpt-ossより書き込み速度は遅くなります。一方、コンテキストが長くなっても書き込み性能を最もよく維持するモデルで、16,5から32 768トークンでは約3 %の低下です。
- Qwen3-235B-A22Bは別枠
- Q2_K_XLで動作します。これは表中で最も強い圧縮(パラメータあたり平均3ビット)です。速度は毎秒17,7トークン、容量は90,5 GBです。このような強い圧縮では、一般に回答品質が低下します。私たちは測定していません。
#メモリの限界:重量でおよそ100~105 GB
システムからは121.7 GBのメモリが見えます。128 GBの一部は起動時から予約されています。マシンを起動した後、ほかに何もメモリへ置かない状態では、タイミングによって108~113 GBが使用可能でした。上限を調べるため、最大モデルのより大きな2つのバージョンを、32 768トークンの同じコンテキストでロードし、空きメモリが3 GBを下回った場合にロードを停止する安全策を設けました。
| モデル | ファイル | 使用メモリ | 残りのメモリ | 書き込み(読み込みトークン数4 000 → 30 000) | Place |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B (Q4_K_XL) | 103,7 GB | 107,0 GB | 6.0 GB | 24,9 → 21,9 tok/s | ぎりぎり |
| Qwen3-235B-A22B(Q3_K_XL、3.5ビット) | 97,0 GB | 104,7 GB | 8,2 GB | 13,9 → 10,4 tok/s | ぎりぎり |
どのモデルも読み込みに失敗しませんでしたが、この二つには余裕がほとんどありません。二つ目のモデル、はるかに長いコンテキスト、または横で動かす負荷の高いアプリケーションを置く余地はほぼありません。したがって、実用上の上限は重量でおよそ100~105 GBです。たとえば、Qwen3.8-Flash-NextのNVFP4重量(NVIDIAの圧縮形式)は対象外です。Kubesimplifyのブログ(2026年8月27日)によれば約135 GBで、その場合は二台のマシンが必要だと説明されています。
同じ記事では、モデルを単一マシン上でGGUF(llama.cppの形式)として動かす方法もすでに示していましたが、その時点では最も圧縮されたバージョンしか存在しませんでした。ATOMでは、IQ4_XSとQ4_K_XLのバージョンが動作し、それぞれ21 GBと6 GBの余裕があります。
#長いコンテキストの料金
長い文書、コードベース、または長く続く会話では、コンテキストにすでに存在する各トークンが後続の処理を遅くします。メモリ上に32 768トークンがある場合、モデルによって書き込み速度は3~47 %低下します。また、30 000トークン、五十ページほどの文書を一括で読み込む実時間も測定しました。
| モデル | 30 000トークンの読み込み | 続いて書き込み |
|---|---|---|
| Gemma 3 4B | 4,7 s | 60,8 tok/s |
| gpt-oss 20B | 8,1 s | 61,6 tok/s |
| Qwen2.5-Coder 7B | 12,7 s | 23,3 tok/s |
| Qwen3.6 35B-A3B | 14,2 s | 54,4 tok/s |
| Qwen3-Coder 30B-A3B | 17,4 s | 33,3 tok/s |
| gpt-oss 120B | 21,8 s | 42.8 tok/s |
| GLM-4.7-Flash | 32,7 s | 35.6トークン/秒 |
| Qwen3.8 27B | 39,4 s | 10,6 tok/s |
| Qwen3.8-Flash-Next 125B | 42,9 s | 23,0 tok/s |
| Qwen3.5 122B-A10B | 43,6 s | 21,2 tok/s |
| Nemotron-3 Super 120B-A12B | 55,4 s | 毎秒16.2トークン |
| Qwen3-235B-A22B | 1分33秒 | 12,1 tok/s |
| Llama 3.3 70B | 1分44秒 | 4,0 tok/s |
ほとんどのモデルでは、これらの時間は最初の表の「読み込み」列が示す値より長くなります。おそらく、実際に使用するサーバーであるllama-serverは、llama-benchの設定である2,048ではなく、デフォルトで512トークンずつバッチ処理するためです。
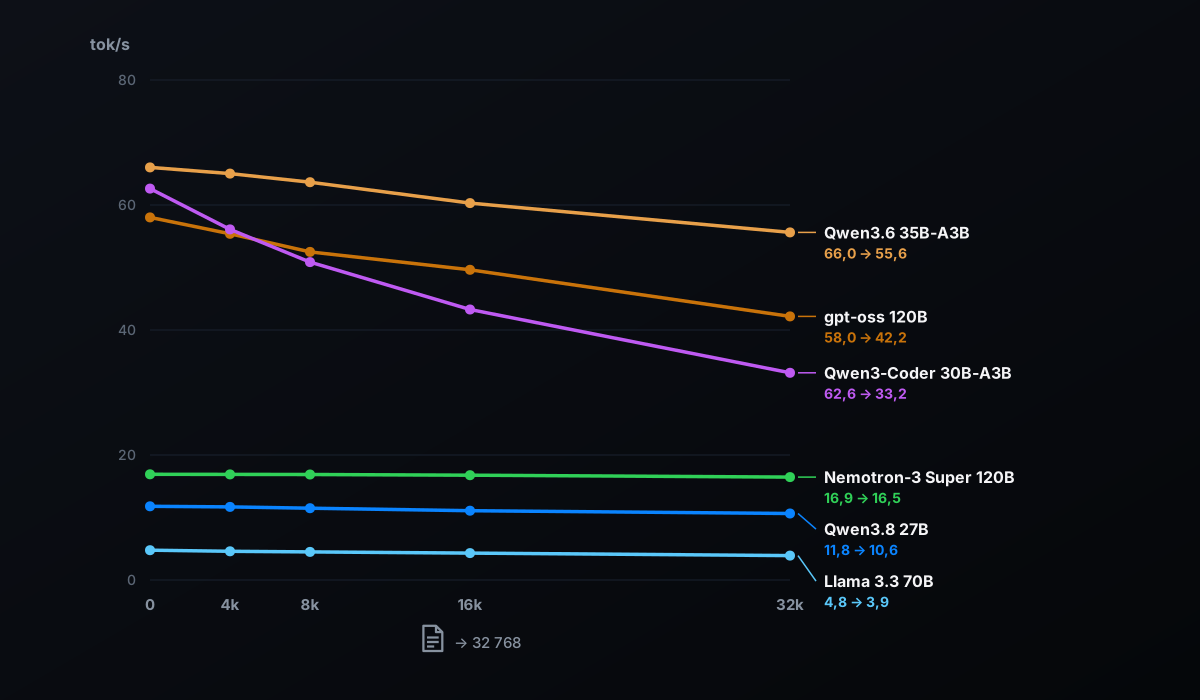
読み取りはGB10の強みです。下で比較するMacと比べて、gpt-oss 120Bは31 %速く読み取ります。五十ページほどのレポートを投入すると、gpt-oss 120Bでは22秒後に、密な70Bモデルでは1 min 44 s後に応答が始まります。文書分析やコードエージェントでは、この基準が大きな重みを持ちます。
#同時に最大16ユーザーまで:マシンが処理できる範囲
vLLMを使い、同時接続ユーザー数1、8、16でシミュレーションしました。各ユーザーは1 024トークンのリクエストを送信し、512トークンの応答を受け取ります。各ポイントは異なるリクエストで3回測定し、中央値を公開しています。
| モデル | ユーザー | Total | ユーザーあたり | 最初のトークン(平均) | 最初の単語(最も遅いケース) |
|---|---|---|---|---|---|
| gpt-oss 120B | 1 | 35.6トークン/秒 | 36,4 tok/s | 0,34 s | 0,35 s |
| gpt-oss 120B | 8 | 113,9 tok/s | 14.5 tok/s | 0,97 s | 1,62 s |
| gpt-oss 120B | 16 | 毎秒160.3トークン | 10,2 tok/s | 1,07 s | 3,71 s |
| gpt-oss 20B | 1 | 49,1 tok/s | 50,0 tok/s | 0,16 s | 0,16 s |
| gpt-oss 20B | 8 | 205,9 tok/s | 26,5 tok/s | 0,49 s | 0,81 s |
| gpt-oss 20B | 16 | 322,4 tok/s | 20,7 tok/s | 0,52 s | 1,73 s |
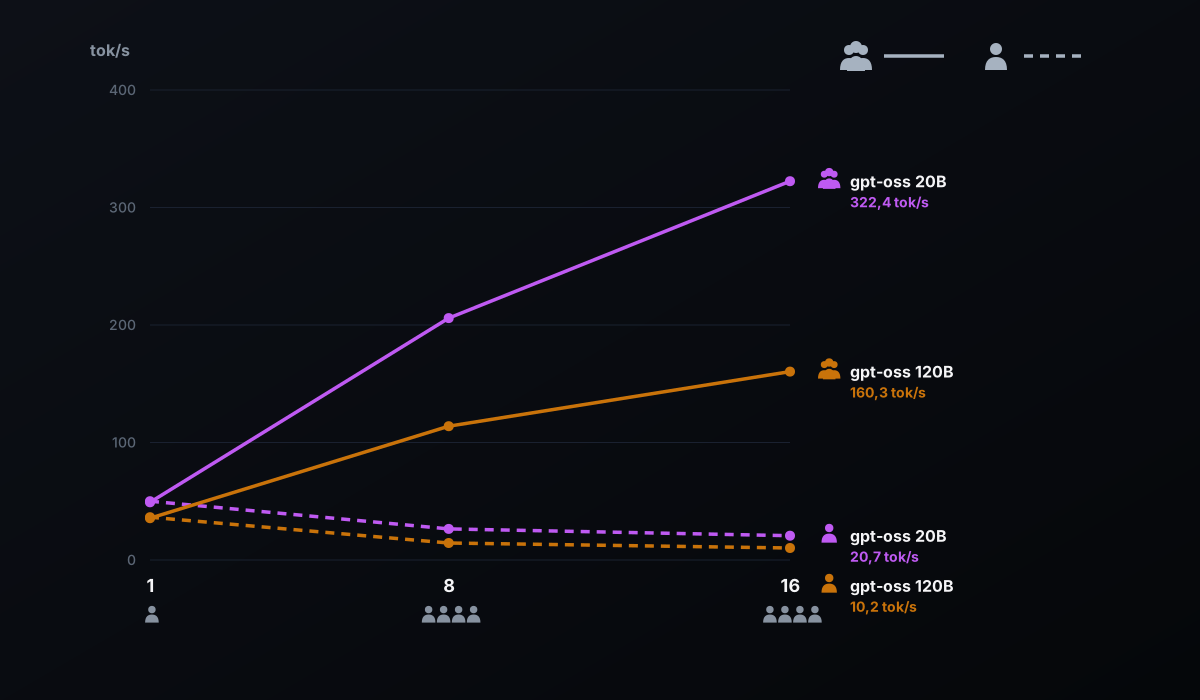
ユーザー数が1人から16人になると、総スループットは gpt-oss 120B で4.5倍、gpt-oss 20B で6.6倍になります。複数のリクエストが同じ重みの読み込みを共有すると、チップは計算能力を最大限に活用します。
16人が同時に使う場合でも、gpt-oss 120Bではそれぞれの回答が毎秒10トークン、gpt-oss 20Bでは毎秒21トークンで、まだ生成されていく様子を確認できます。1200億パラメーターのモデルでは、最初の単語が平均で1秒強、遅いケースでは約4秒で表示されます。
ただし、一人で使う場合、vLLMは最速ではありません。特別な性能設定をしない場合、gpt-oss 120Bでは毎秒36,4トークンで書き込みます。長い応答では、llama.cppの54,4に対して遅くなります。ログを見ると、GB10ではMXFP4形式にMarlin計算カーネルを選択しており、これが差の原因である可能性が高いと考えられます。複数の人や複数のエージェントがマシンを共有する場合には、vLLMを使う意味があります。
#マシンの前で一人:Ollamaとllama.cppのどちらを使うか?
Ollamaは始めるのに最も簡単な方法で、設定なしでGB10上で動作します。ただし、gpt-ossでは最速ではありません。長い応答では、バージョン0.34.1はgpt-oss 120B上で毎秒42,3トークンを書き出すのに対し、同じMXFP4形式のllama.cppは54,4で、22 %少なくなっています。gpt-oss 20Bでは58,8対78,8で、25 %少なくなっています。
Qwenのモデルでは逆です。Qwen3.8 27Bでは、Ollamaは文章によって毎秒22,9~30,5トークンを出力するのに対し、デフォルト設定のllama.cppは11,8です。Qwen3.6 35B-A3Bでは90,5~94,9に対し、66,0です。おそらくその理由は、Ollamaがここでデフォルトで投機的デコードを有効にしているためです。これはモデルが一度に検証する複数の先行トークンを提案します(これらのモデルの設定にはdraft_num_predictという項目があります)。
当方のテストもこの傾向を示しています。llama-server上で(400トークンのテキスト六本、散文とコード)、llama.cppの投機的デコード(MTP、複数のトークンを同時に予測する方式)により、Qwen3.8 27Bは散文で毎秒11,7トークンから21,5トークンへ、コードで11,6から27,2へ向上しました。
実際には、起動にはOllamaを使い、モデルにはQwenを使います。後者は標準で高速化されます。gpt-ossの性能を最大限に引き出すにはllama.cppを使うか、投機的デコードを有効にしてQwen3.8を使います。最適な選択はマシンよりも設定に左右されます。
#MacBook Pro M5 Max 128 GBと比べると
ある読者は9月16日に、Ollama 0.34.1を使い、MacBook Pro M5 Max 128 GB(40コアGPU)をモデルごとに1回だけ通して測定しました。その測定結果は専用ガイドで公開されています。当方はATOMでも同じ系列を2回通して再実行しました。Ollamaのバージョン、モデル、プロンプトは同一です。
| 測定 | ATOM、1erパス | ATOM、第2回 | MacBook Pro M5 Max | 差 |
|---|---|---|---|---|
| 書き込み、gemma4:12b | 45,9 | 54,1 | 58,1 | Mac +7~+27 % |
| 書き込み、qwen3.8:27b | 30,5 | 22,9 | 36,6 | Macは+20~+59% |
| 出力、gpt-oss:20b | 58,1 | 58,8 | 113,4 | Mac +93~+95 % |
| 書き込み、gpt-oss:120b | 42,2 | 42,3 | 79,1 | Mac +87 % |
| 読み取り、gpt-oss:120b | 1 816 | — | 1 388 | ATOM +31 % |
Macは四つのモデルすべてでより高速に書き込み、二つのgpt-ossではほぼ二倍高速です。この二つでは測定結果も一致しており、MacのチップはGB10の二倍を超える614 GB/sの帯域幅を備えています。gemma4とqwen3.8では、差は実行ごとに変動します。生成されるテキストによって効果が変わる投機的デコードが、その説明の一つとして考えられます。
ATOMの読み取りはより高速です。これはおそらくGPUの計算性能によるもので、似ているものの同一ではないテキスト(16 850トークンと16 689トークン)で比較しています。llama.cppでは書き込み速度の差が縮まり、gpt-oss 120Bでは毎秒54,4トークン、Ollama上のMacでは79,1トークンです。
#ATOMが適している人
以下はATOMでの測定結果です。
- 自宅で大規模モデルを使いたいなら、ATOMが適切な選択です
- 1000億を超えるパラメータのモデル五つなら、余裕を持って収まります。私たちの知る限り、一般向けのグラフィックカードでこの128 GBに近づくものはありません。
- …長い文書やコードを扱う場合
- gpt-oss 120B で30,000トークンを22秒で読み込み。
- …複数のユーザーまたはエージェントで共有する場合
- gpt-oss 120Bでユーザー16人を処理した場合、合計で毎秒160トークン
- … NVIDIAのエコシステムが欲しい場合は
- CUDA 13、NVIDIAコンテナ内のvLLM、そしてGB10チップ向けにコンパイルしたllama.cppは、DGX OS 7.5.0上で当方では動作しました。
- 一人で作業し、まず生成速度を重視する場合
- MacBook Pro M5 Maxと比較してください。614 GB/sにより、gpt-ossへの書き込みはより高速です。一方、ATOMはgpt-oss 120B上の長いドキュメントを31 %高速に読み取ります。価格も比較してください。
- モデルが 35 GB 未満に収まる場合
- 2026年10月23日に発表されたATOMの64 GB版で十分なはずです(計算は当社の測定から導いたもので、このバージョンでの実測ではありません)。
#64または128 GB?
2026年10月2日、NVIDIAは最大1,000億パラメーターのモデルに対応する64 GBのDGX Sparkを発表しました。Acer、ASUS、Dell、GIGABYTE、HP、MSIから10月23日に発売され、価格は4 999ドルからです。GIGABYTEは10月5日、同じデザインのAI TOP ATOM 64 GBを確認しました。これは測定していません。
私たちの測定結果から計算できます。Qwen3-Coder 30B-A3Bまでのモデルは、32 768トークンのコンテキストで35 GB未満しか使用せず、収まるはずです。Llama 3.3 70B(51 GB)は限界でしょう。gpt-oss 120B(62 GB)と、それより大きいモデルは収まりません。同じ帯域幅であれば、検証が必要ですが、速度は近くなるはずです。
1台のマシンで1000億パラメーターを超えるモデルを動かすなら、128 GB版が必要です。NVIDIAによれば、64 GBのマシン2台を接続してメモリを共有することもできますが、私たちはテストしていません。
#確認した価格
2026年10月8日時点で、PCIe 4.0の4 TB版(ATAGB10-9001、GB10チップと128 GBは同じ)は、AORUS公式ショップで税込6 346,27 €と表示されていましたが、在庫切れでした。Amazon.frでは、Amazon UKによる販売分(1台)が在庫ありでした。テストしたPCIe 5.0の4 TB版(ATAGB10-9000)は、LDLCとMateriel.netで7 999,95 €、在庫切れでした。
これらのマシンの価格と在庫はすぐに変わります。購入前に確認してください。
#私たちの評価
ATOMは、1200億パラメーターのモデルを自宅で動かしたり、チームで共有したり、長い文書をすばやく読んだりするのに最適な選択肢です。私たちの測定では、熱による制限は確認されず、16ユーザーが1時間連続で負荷をかけた場合も含めて、プラットフォームの基準性能を示しました。予算を重視するなら、PCIe 4.0版でも同じチップと同じメモリを維持しています。
#測定していないこと
- 回答の品質
- このガイドで測定しているのは、各モデルの価値ではなく、何が動作し、どの程度の速度が出るかです。
- 温度、騒音、消費電力
- このシリーズの次のガイドでは長時間負荷時の温度を詳しく説明します。消費電力については専用ガイドがあり、チップ上で読み取った値です(GPU単体)。騒音については、Hardware & Co.の測定値を引用します。
- 32 768トークンを超えるコンテキスト
- より長いコンテキストに対応するモデルはいくつもありますが、このガイドでは32 768トークンまでに留めています。同シリーズの70Bチュートリアルでは、Llama 3.3 70Bとgpt-oss 120Bについて131 072トークンまで扱います。
- その他のGB10マシンと64 GB版
- 私たちの数値はNVIDIAのDGX Sparkについて公開されている数値と一致しますが、測定したのはATOM 128 GBだけです。
更新と修正:DGX OS、llama.cpp、またはOllamaの新しいバージョンによってこの結果が変わった場合、このページを改訂し、各修正に日付を付けます。
#FAQ
128 GBの GB10 マシンで動かせる最大のモデルはどれですか?+
GB10上で70Bモデルを日常的に使えますか?+
このガイドの速度は、NVIDIAのDGX Sparkや別ブランドの製品にも当てはまりますか?+
64 GB版と128 GB版のどちらを選ぶべきですか?+
OllamaはGB10マシンで最良の選択ですか?+
ご意見、誤りのご指摘、補足はありますか?ぜひお知らせください。皆さんにとってより良いガイドにするために役立ちます。