AI TOP ATOMとDGX Sparkの違い 実際のものですか?
GIGABYTE AI TOP ATOMとNVIDIAのDGX Sparkは、同じGB10チップと同じ128 GBメモリを搭載しています。私たちの測定値は、llama.cpp使用時にDGX Sparkについて公開された値との差が最大4.3 %、Ollama使用時は2 %以内です。GIGABYTEは独自の筐体(Founders Editionと同じ1リットル形式)、冷却機構、六つのリファレンスを提供しています。2時間の連続負荷中、速度は安定しており、強制的な低下はありませんでした。
NVIDIAのDGX SparkとGIGABYTEのAI TOP ATOMは、同じGB10チップを基盤としています。実際に変わるのは何でしょうか。GIGABYTEから無償提供されたAI TOP ATOMで、DGX Sparkについて公開された三つの測定シリーズを再実行し、その後、1時間および2時間の負荷時の安定性、温度、SSDを測定し、ポートを確認しました。型番ごとの価格と購入に関するアドバイスを続けて紹介します。
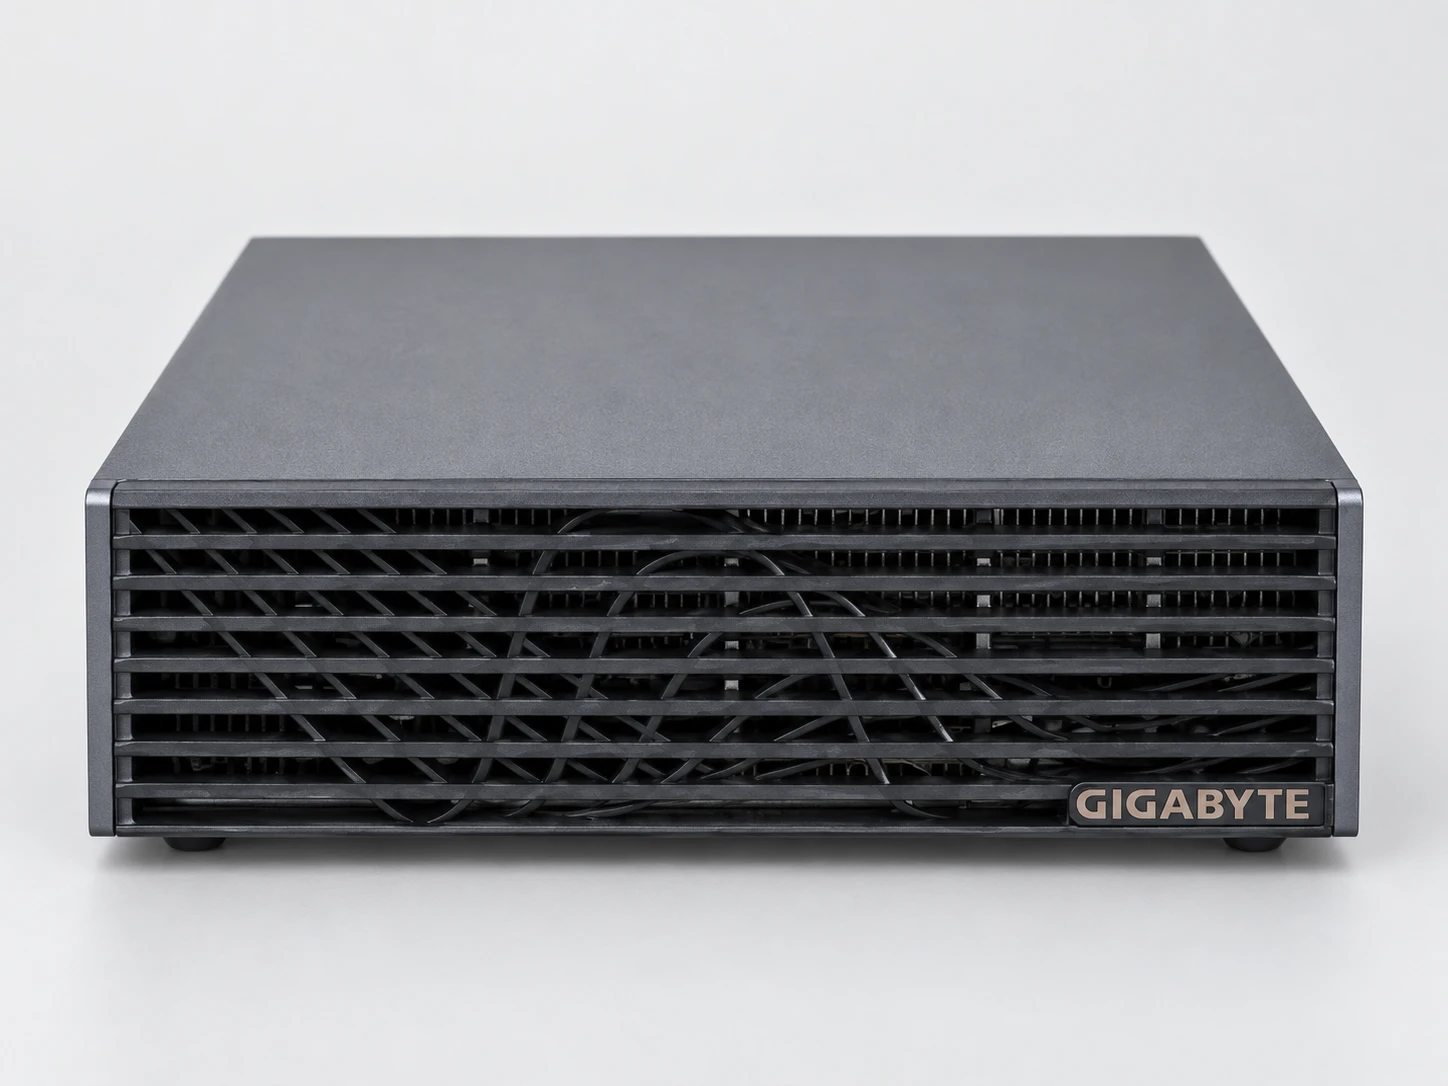
#同じNVIDIA GB10チップ、GIGABYTE製
DGX SparkはNVIDIAのプラットフォームです。GB10チップにはArmコア20個とBlackwell世代のGPUが統合されており、発表上は273 GB/sの帯域幅を持つ128 GBのメモリを共有します。NVIDIAはDGX OS、ドライバー、CUDAも提供します。NVIDIAが販売するDGX SparkはFounders Editionと呼ばれます。GIGABYTEを含む他のメーカーも、同じ基盤で独自のマシンを提供しています。
この区分がガイド全体の構成を決めています。NVIDIAに由来するものはすべてのGB10マシンに共通します。次のセクションで測定により確認します。GIGABYTEに由来するものは、筐体、冷却、ストレージ、型番、保証の観点から評価します。アメリカのハードウェアテストサイトであるStorageReviewは、これらのマシンがすべて同じGB10基盤を共有しているため、AI性能の差は小さいと記しています。
| 項目 | 提供元 | 私たちのAI TOP ATOMでは |
|---|---|---|
| GB10チップ:20個のArmコア、Blackwell GPU | NVIDIA | 公開値との差が5 %未満の速度(次のセクション) |
| 128 GBのユニファイドメモリー、273 GB/s | NVIDIA(プラットフォーム) | システムが認識する容量は121,7 GBで、その一部は起動用に予約されています |
| DGX OS、ドライバー、CUDA | NVIDIA | DGX OS 7.5.0、ドライバー580.159.03、CUDA 13.0 |
| 150 × 150 × 50.5 mm、1.2 kgのサイズ | Founders Editionと同じ形式 | マットブラックの筐体、ポートもボタンもないスラット式フロントパネル |
| 冷却と仕上げ | GIGABYTE | ServeTheHomeによると、ヒートシンク、銅プレート、ヒートパイプ、二基のファン |
| SSD:容量とPCIe世代 | GIGABYTE(型番による) | 4 TBのSamsung、検証済みPCIe 5.0(4レーンで32 GT/s) |
| USB-Cによる240 W電源 | GIGABYTE(アダプター付属) | NVIDIAでは、付属の電源を使用する必要があります |
| 型番、価格、保証 | GIGABYTEおよび販売店 | 仕様と価格のセクションを見る |
#DGX Sparkと同じ速度:三つの確認
ATOMとDGX Sparkの基準値を比較するため、同じツールを使ってこのマシン向けに公開された測定を三つ再現しました。llama.cppとOllamaでは、バージョンと設定も同じです。vLLMについては、バージョンとコマンドが公開されていません。私たちのATOMが同じ数値を出すなら、基準値と同じ性能を発揮します。
#方法と単位
llama.cppの各速度は5回の反復の平均で、標準偏差は3%未満です(標準偏差は反復結果のばらつきを測定します)。読み取り速度は、応答前にマシンがテキストを取り込む速度です。書き込み速度は、応答が表示される速度です。
どちらも毎秒トークン数(tok/s)で測定します。トークンとは単語の一部で、フランス語ではおよそ単語の3分の2に相当します。メモリとディスク速度は、Linuxの表示に合わせてGoおよびGo/sで示します:1 GB = 1,024 MB。
プロトコルは最初の測定前に確定しました。その後に追加した各テストは、テスト前に作成した日付入りの追補で説明しています。手法、追補の日付入り一覧、表のデータは、手法のページで公開しています。
#llama.cpp使用時:4.3 %以内
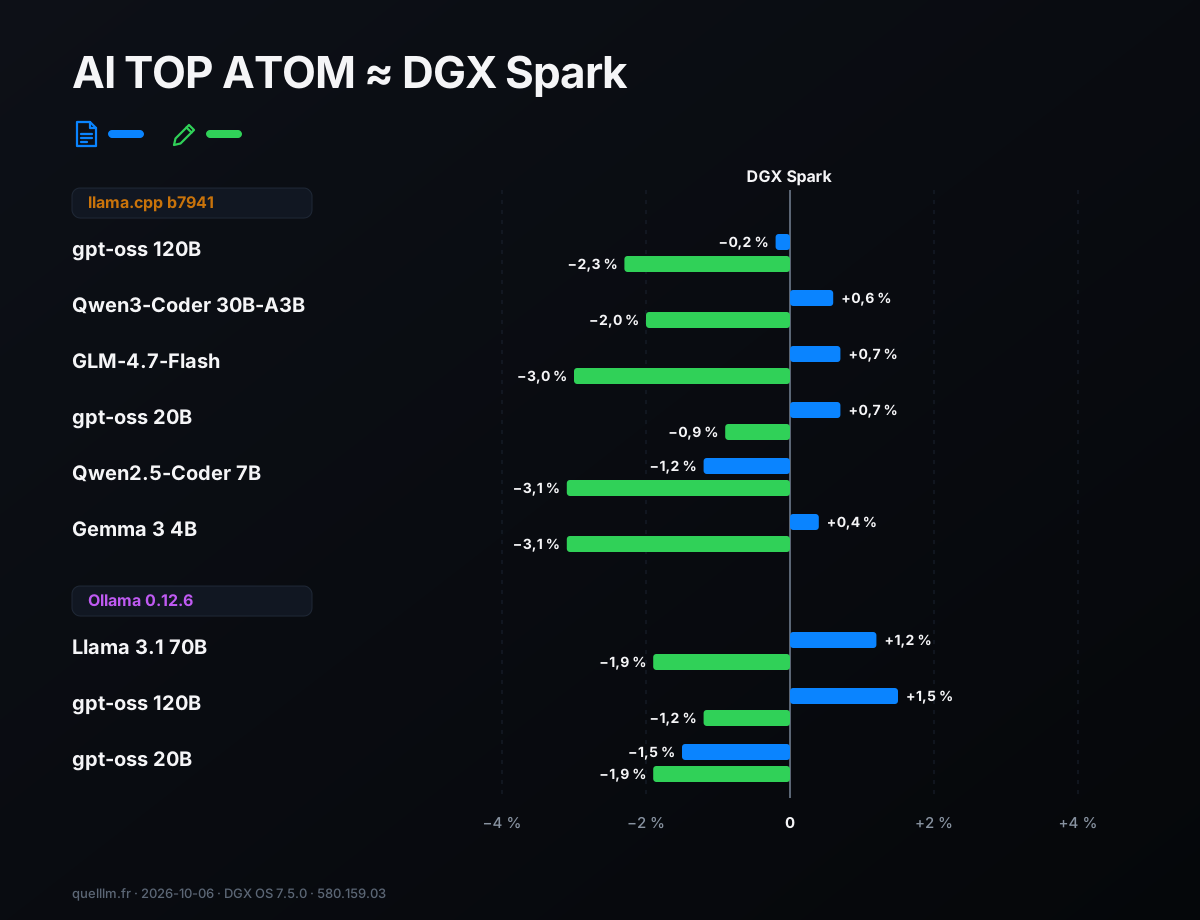
llama.cppは、モデルをローカルで実行するために広く使われているオープンソースのエンジンです。プロジェクトは2026年2月、DGX Spark向けに、ビルド7941(ソフトウェアのバージョン番号)で基準値の表を公開しました。私たちは同じビルドをコンパイルし、六つのモデルと五つのコンテキスト長で同じコマンドを実行しました。測定点は合計60点です。コンテキストとは、すでにメモリに存在するテキストで、0~32 768トークンです。
結果:読み取り速度は最大2.3%の差で同一で、中央値の差は+0.3%でした。書き込み速度も同じ水準を維持し、中央値の差は−2.8%(最大4.3%)でした。gpt-oss 120Bでは、空のコンテキストでの読み取りは基準値と同じで、両方とも2 443,9 tok/sでした。基準表は、当方のもの(580.159.03)より古いドライバー(580.95.05)に基づいています。
#Ollamaの公式スクリプトでは:差は2%以内
Ollamaは、2025年10月にDGX Sparkの独自測定値を公開しました。使用したのはバージョン0.12.6とドライバー580.95.05です。私たちは同じバージョンと同じスクリプトを使用し、10回の実行と温度0で測定しました。公開された三つのモデルは、読み取りでも書き込みでも2 %以内の結果を示しています。
| モデル | 読み取り:私たち/公開済み | 差 | 書き込み:当サイト/公開値 | 差 |
|---|---|---|---|---|
| gpt-oss 20B | 3 175,0 / 3 224 | −1,5 % | 57,18 / 58,27 | −1,9 % |
| gpt-oss 120B | 1 186,8 / 1 169 | +1,5 % | 40,65 / 41,14 | −1,2 % |
| Llama 3.1 70B | 1 933,6 / 1 911 | +1,2 % | 4,34 / 4,423 | −1,9 % |
#vLLMでは:同程度の規模、異なるエンジン
StorageReviewは、複数の人に同時に応答するよう設計されたサーバーvLLMを使い、gpt-oss 120B上で2026年3月3日にATOMを測定しました。StorageReviewはvLLMのバージョンも正確なコマンドも公開していません。私たちは、1ユーザーおよび64ユーザーについて、vLLM 26.09で三つのシナリオを再実行しました。
私たちのスループットは、シナリオによって上回る場合も下回る場合もありますが、StorageReviewと同程度です。1ユーザーで、マシンが4 096トークンを読み取り、512トークンを書き込むシナリオでは、合計304,4トークン/秒でした。StorageReviewは304,6でした。
64ユーザーで、バランスの取れたシナリオ(読み取り256トークン、書き込み256トークン)では、毎秒695トークンに達しました。650トークンに対してです。vLLMのバージョンが同一ではないため、これらの数値は同程度の規模を示すものとして提示しており、マシンの比較ではありません。これらの試験中、リクエストが中断されることはありませんでした。
要約すると、ローカルで広く使われている二つのエンジン、llama.cppとOllamaでは、ATOMは5 %未満の差でDGX Sparkと同じ性能を示します。このチップでの各モデルの速度については、シリーズ第一弾のガイドをご覧ください。
#GIGABYTEが提供するもの:シャーシ、冷却、仕様
AI TOP ATOMのサイズは150 × 150 × 50,5 mm、重さは1,2 kgで、容積はおよそ一リットルです。Founders Editionと同じサイズです。本体はマットブラックです。前面は波打つ模様のスリット構造で、ポートもボタンもありません。すべて背面に接続します。
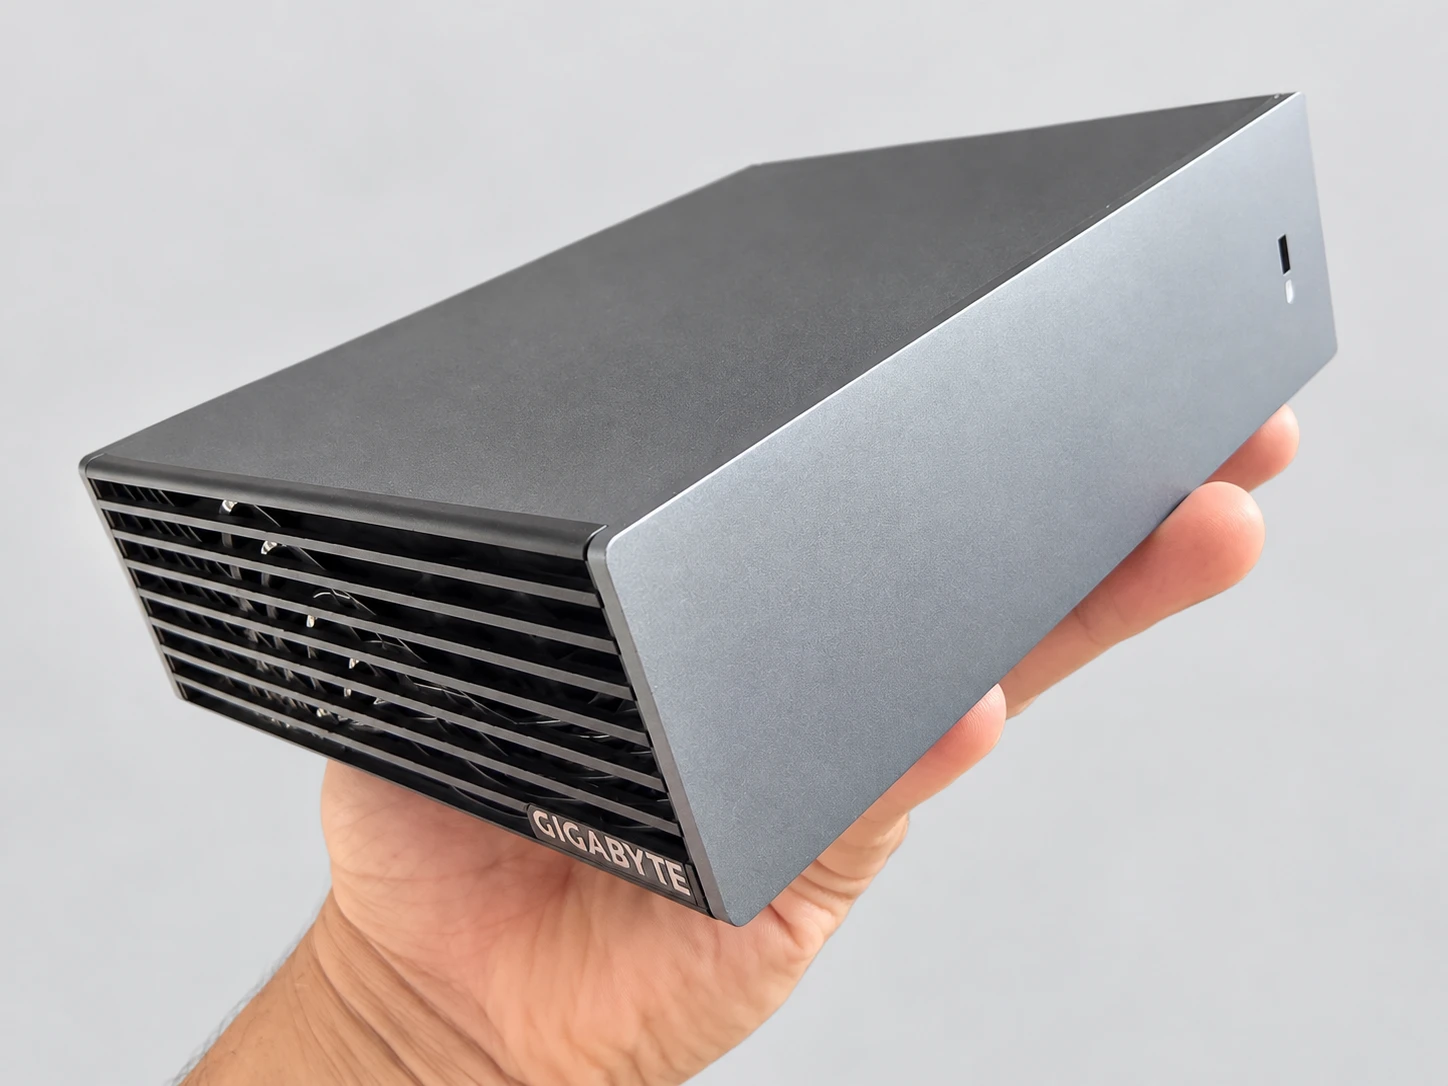
ServeTheHomeはマシンを分解しました。同サイトは、チップ上の銅板とヒートパイプを備えた大型ヒートシンクが、二つのDelta製ファンで冷却されていると説明しています。StorageReviewは2026年1月にGB10マシン五台を比較しました。GIGABYTEは高負荷時のピークで最大87〜88 °Cに達し、Founders EditionおよびDellのマシンと同程度でした。
StorageReviewは、冷却性能の最上位クラスの一つに位置付けており、GPUの電力レベルも最も高い部類に入るとしています。1時間以上の連続負荷の後、ServeTheHomeはATOMをNVIDIAのDGX Sparkと同程度と評価しており、複数のAIテストではわずかに上回りました。
2026年7月から大学の研究室でATOMを使用しているPeter Falkinghamは、テストでほとんど無音だと評価しています。
#選択可能なSSDを含む6つのリファレンス
GIGABYTEの製品ページには、ATAGB10-9000からATAGB10-9005まで六つの型番が掲載されています。表には、私たちが確認できたものを示しています。
| 参考 | メモリ | SSD |
|---|---|---|
| ATAGB10-9000(当社のユニット) | 128 GB | PCIe 5.0の4 TB |
| ATAGB10-9001 | 128 GB | PCIe 4.0の4 TB |
| ATAGB10-9002 | 128 GB | PCIe 4.0接続の1 TB |
| ATAGB10-9003~9005 | 128 GBまたは64 GB | PCIe 4.0の2 TBまたは1 TB(リファレンスごとの検証は未実施) |
9000のSSDはPM9E1シリーズのSamsung製で、StorageReviewによればFounders Editionと同じモデルです。M.2 2242モジュールです。ServeTheHomeによれば、ユーザーが交換できる唯一のコンポーネントです。
#電源、筐体、保証
240 Wのアダプターは、電源専用のUSB-Cポートに接続します。NVIDIAは、最適な性能を得るために付属の電源を使用するよう求めています。箱には、マシン本体、アダプター、電源コードが入っています。2台のマシンを接続するQSFPケーブルはGIGABYTEが別売りしており、AORUS公式ショップで税込94,04 €です(2026年10月8日確認)。
保証について、GIGABYTEのマニュアルには、期間は製品サイトまたは製品ラベルに記載されているとあります。LDLCは9000について5年間の保証を案内しています(2026年10月8日確認)。購入前に販売店の商品ページで保証期間を確認してください。
#ポートと接続端子
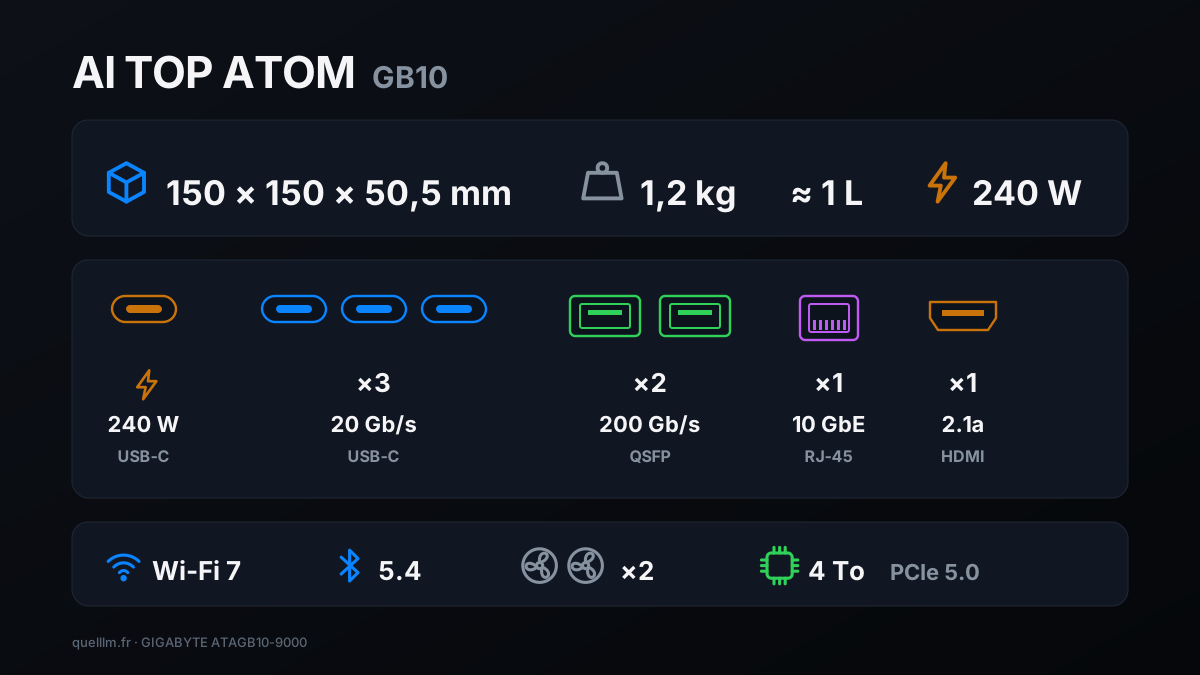
この一覧はGIGABYTEの製品ページを基にしており、Founders EditionのNVIDIAの製品ページにも同じポートが記載されています。私たちの個体では、有線ネットワークとSSDの接続を確認し、Wi-Fiモジュールを特定しました。
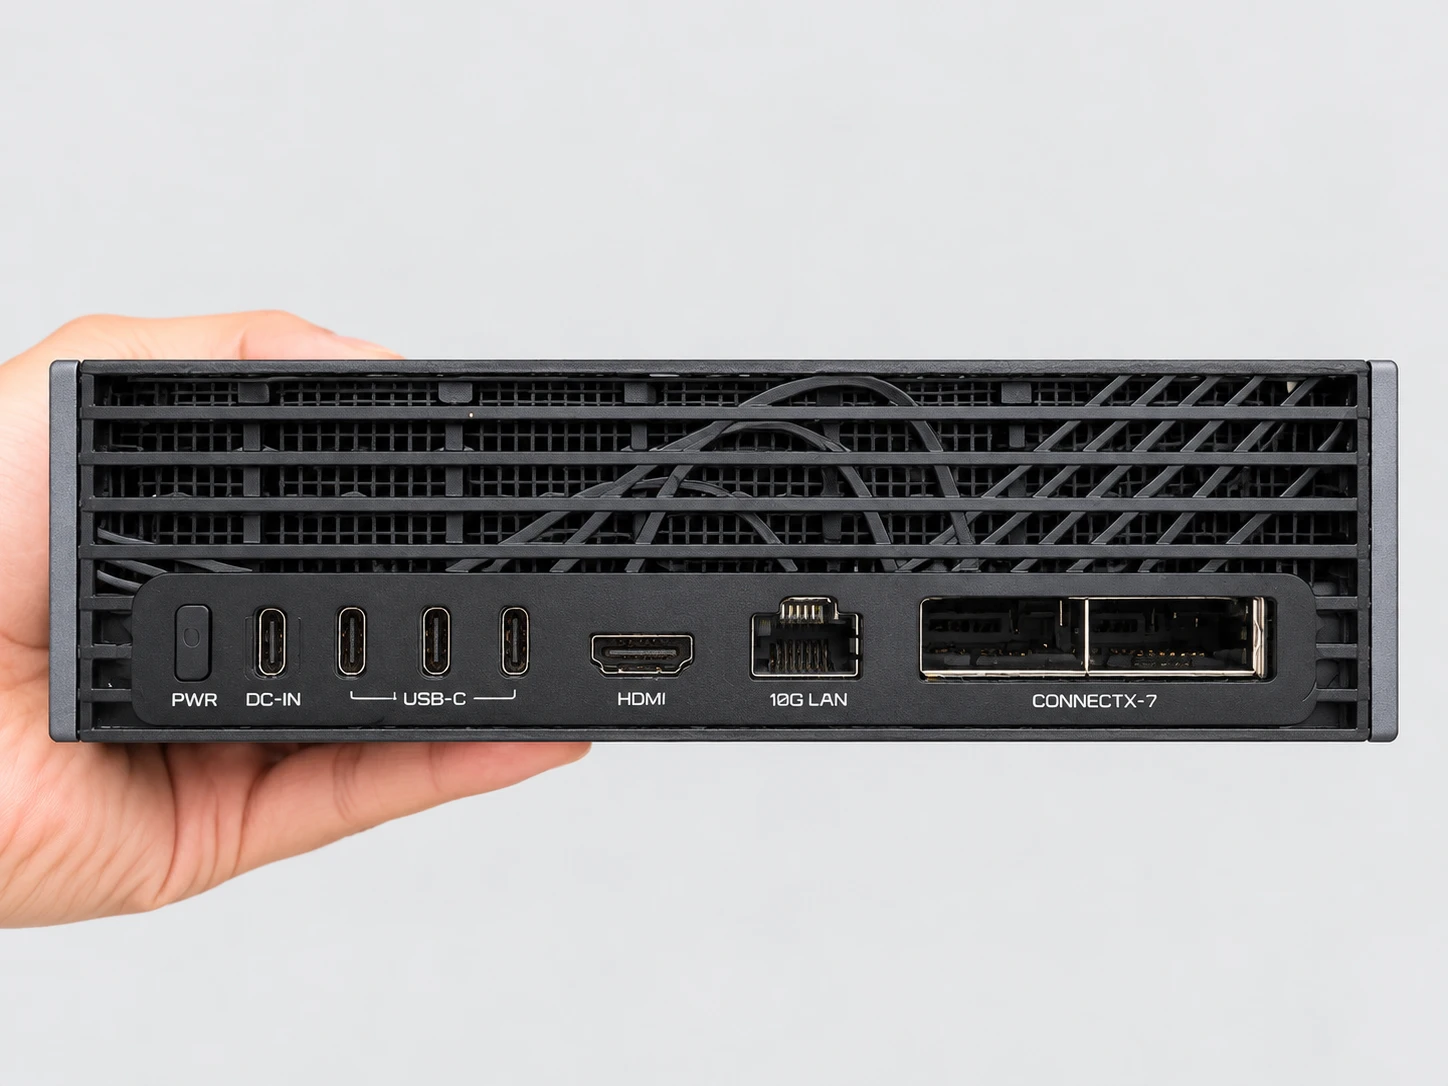
- 電源
- 給電専用のUSB-Cポートと、付属の240 Wアダプター。
- USB
- ディスクやアクセサリー用の20 Gb/s対応USB-Cポート三つ(USB 3.2 Gen 2x2)。
- 有線ネットワーク
- 10 GbEのRJ-45ポート一つ。私たちの個体では、ネゴシエートされたリンク速度は10 Gb/sです。
- 高速ネットワーク
- 複数のマシンを接続するためのQSFPポート2基(NVIDIA ConnectX-7カード、200 Gb/s)。この接続はテストしていません。
- 動画
- マルチチャンネル音声対応のHDMI 2.1a出力。
- ワイヤレス
- Wi-Fi 7およびBluetooth 5.4。システムではMediaTek MT7925チップを確認しました。
#負荷時の持続性能:1時間および2時間連続
コンパクトなマシンは、速度低下なしに負荷を処理できなければなりません。熱または電力制限によって強制的に速度が低下することをスロットリングと呼びます。ATOMではvLLM 26.09を使い、休止なしで処理を実行しました。各セッションはスライスに分割されます。スライスとは、直前のものに続けて送信されるリクエストのまとまりです。その間、GPUのクロック、電力、温度、ドライバーが報告するスロットリングの理由を毎秒記録しました。
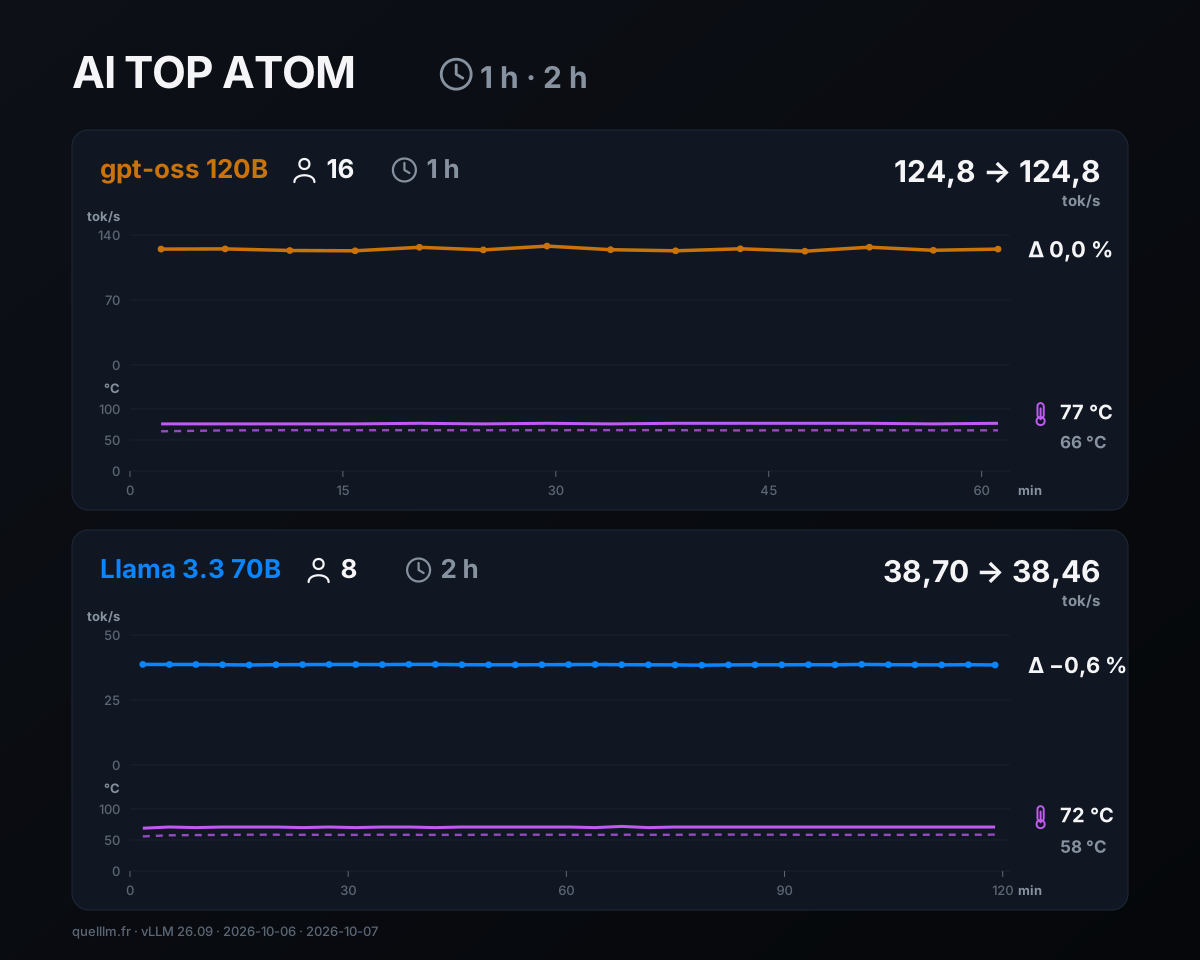
| セッション | リクエスト | スループット:最初のスライス → 最後のスライス | ドリフト | GPU温度 | Bridage |
|---|---|---|---|---|---|
| 1時間、gpt-oss 120B、16ユーザー、14スライス | 896、失敗なし | 124.8 → 124.8(122.6から128.1) | 0,0 % | 77 °C / 66 °C | なし |
| 2時間、Llama 3.3 70B NVFP4、8ユーザー、33区間 | 1 056、失敗なし | 38.70 → 38.46(38.40~38.70) | −0,6 % | 72 °C / 58 °C | なし |
1時間にわたり、16ユーザーが4,096トークンのリクエストを連続して送り、512トークンの応答を受けました。64リクエストの14区間では、合計スループットが122.6~128.1 tok/sとほぼ同一で、最初と最後はいずれも124.8 tok/sに達しました。各ユーザーには、応答が約8 tok/sで出力されているように見えました。このセッションでのGPUクロックの中央値は2,509 MHzでした。
二時間にわたり、8ユーザーがLlama 3.3 70BのNVFP4形式で作業しました。これはNVIDIAを圧縮した形式で、各リクエストは読み取り1,024トークン、書き込み256トークンでした。合計スループットは、32リクエストの33区間で38.40~38.70 tok/sの範囲に収まりました。
変動は最初の区間と最後の区間の間で−0.6%、最初の五区間と最後の五区間の中央値を比較すると−0.2%です。各ユーザーには、応答が約5.1 tok/sで出力されているように見え、最初の単語は2.8秒で到着しました(中央値)。GPUクロックの中央値は2,528 MHzでした。
ドライバーは二回のセッション中、スロットリングの理由を一つも報告しませんでした。測定値は秒ごとにゼロのままでした。GPUの最高温度は、16ユーザー時に77 °C、8ユーザー時に72 °Cに達しました。システムセンサーで最も高温だったゾーンは、最初のセッション中に87 °C、二回目のセッション中に80 °Cに達しました。
二回目は、SSDの最高温度が49 °Cに達しました。ファームウェアはこれらのゾーンに名称を付けていないため、プロセッサーのものとはみなしていません。比較として、StorageReviewでは、Founders Edition、Dellマシン、GIGABYTEの負荷ピーク時の最高温度を87~88 °Cと測定しています。
#アイドル時
20分間静置した後、30分間マシンを測定しました。GPUの平均消費電力は10.4 W(10.2~11.0 W)で、温度は35~36 °Cに収まりました。システムセンサーで最も高温になった箇所は最大46 °Cまで上昇し、SSDは34~35 °Cに収まりました。スロットリングの理由は一つも報告されませんでした。
表示されている電力はGPUのもので、GPUのセンサーから取得しています。マシン全体の消費電力を示すものではありません。室温は記録していません。1時間のセッションは夕方の早い時間帯に、2時間のセッションは夜間に実施しました。夜間は室温がより低かった可能性があります。
#SSD:読み取り13 GB/s、1.28百万IOPS
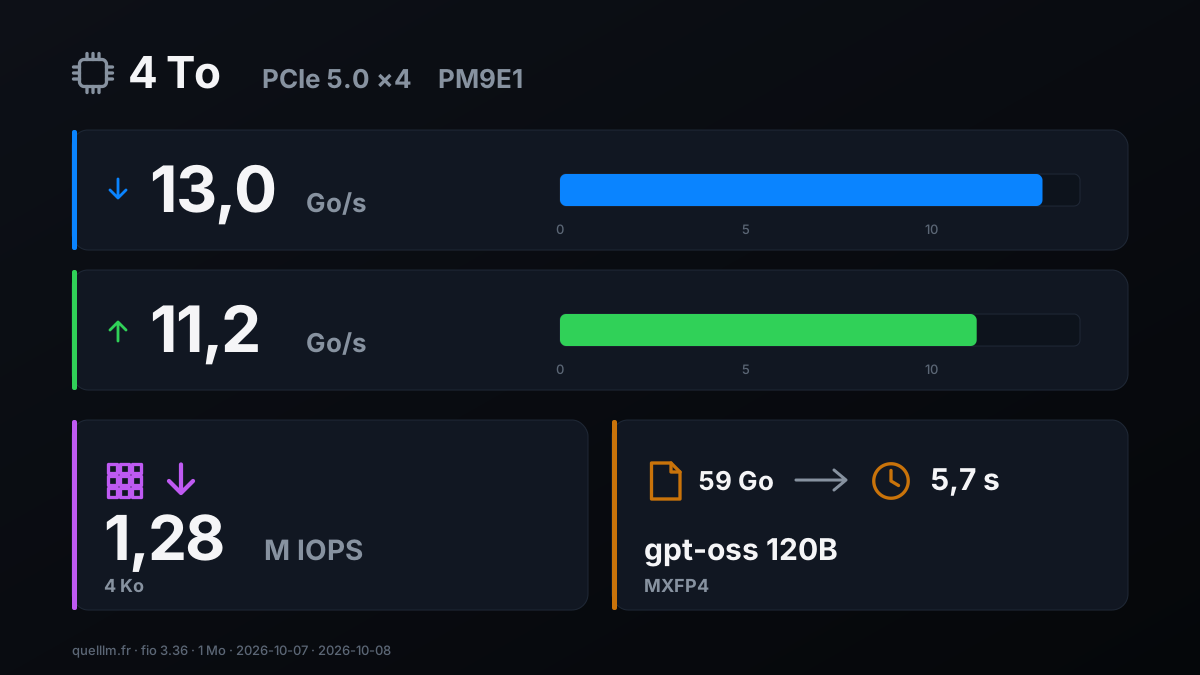
9000リファレンスには、PM9E1ファミリーの4 TB Samsung MZALC4T0HBL1 SSDが搭載されています。システムはPCIe 5.0リンクを確認しています。4レーンで32 GT/sです。PCIeはSSDとチップの間の接続であり、5.0は4.0の二倍の速度です。
fio 3.36を使い、読み取り前に64 GB全体へ書き込みを完了したファイルを、システムキャッシュを経由しない直接アクセスで測定しました。IOPSは、1秒あたりの読み取りまたは書き込み処理数です。
| Test | 結果 |
|---|---|
| シーケンシャル読み取り、1 MBブロック、1タスク | 13.0 GB/s(io_uringでは12.99、libaioでは13.37。いずれもLinuxのディスクアクセス方式) |
| ランダム読み取り、4 KBブロック、4タスク | io_uringで1.28百万IOPS、libaioで1.19百万IOPS(io_uringでは約4.9 GB/s) |
| 連続バースト書き込み、1 MBブロック、新規32 GBファイル、ディスクはアイドル状態 | 11.2 GB/s |
| gpt-oss 120Bファイル(59 GB)の読み込み | 5,7 s |
StorageReviewは、別のツール(gdsio)と同じモデルのSSDを使い、読み取り11,0~11,6 GB/s、書き込み12,2 GB/sを公表しています。私たちの値も同程度で、読み取りはやや高めでした。実際、大型モデルは数秒で読み込めます。59 GBのgpt-oss 120Bファイルは5,7秒で読み込まれました。
9000では、Founders Editionの4 TB SSDを搭載しています。これは同じモデルなので、ATOMとリファレンスNVIDIAを区別する要素にはなりません。GIGABYTEのリファレンス間には違いがあります。9000はPCIe 5.0のSSD、9001と9002はPCIe 4.0のSSDを搭載しています。SSDの測定値はリファレンス9000を対象としています。
#64または128 GB?
2026年10月2日、NVIDIAは最大1,000億パラメーターのモデル向けに64 GBのDGX Sparkを発表し、10月23日からAcer、ASUS、Dell、GIGABYTE、HP、MSIで4,999ドルから販売するとしました。GIGABYTEは10月5日、同じデザインの64 GBのAI TOP ATOMを確認しました。フランスでの提供状況は現時点で確認されていません。私たちは測定していません。
シリーズ初回ガイドの測定結果から計算できます。Qwen3-Coder 30B-A3Bまでのモデルは、コンテキスト長32 768トークンで35 GB未満を占有し、64 GBに収まる見込みです。Llama 3.3 70B(51 GB)は限界に近いでしょう。gpt-oss 120B(62 GB)と、さらに大きいモデルは収まりません。同じ帯域幅であることが前提ですが、確認が必要です。速度は近くなるはずです。
一台のマシンで1,000億を超えるパラメーターのモデルを動かすには、128 GB版が必要です。GIGABYTEのページに掲載された六つの仕様から、メモリーとSSDを選択できます。
#型番別価格(2026年10月8日調査)
GB10の価格は毎週変動します。購入前に確認してください。以下は2026年10月8日にフランスで確認した税込み価格です。必ず同じ型番で比較してください。9001(PCIe 4.0)と9000(PCIe 5.0)は同じマシンではありません。
| Marchand | 参考 | 税込価格 | 表示上の在庫状況 |
|---|---|---|---|
| AORUS公式ショップ | 9001(PCIe 4.0で4 TB) | 6 346,27 € | 在庫切れ |
| Amazon.fr、Amazon UKが販売 | 9001(PCIe 4.0で4 TB) | 価格は変動します。Amazon.frでご確認ください | 1部 |
| LDLC | 9000(PCIe 5.0で4 TB) | 7 999,95 € | Rupture |
| Rue du Commerce、第三者販売業者 | 9000(PCIe 5.0で4 TB) | 7 999,95 €から(3件のオファー) | 販売店による |
| Senetic.fr | 9000(PCIe 5.0で4 TB) | 9 022,08 € | 5台 |
Materiel.netでは9000がLDLCと同じ価格で表示されていましたが、こちらも在庫切れでした。比較のため、同じ日に、別のGB10マシンであるMSI EdgeXpertはMateriel.netで6 599,95 €と表示されており、こちらも在庫切れでした。PNYのDGX Sparkは、Materiel.netでもLDLCでも、すでに取り扱われていませんでした。在庫のないマシンに表示された価格は購入価格ではありません。在庫状況も確認してください。
#測定していないこと
- DGX Sparkとの比較
- この比較は、DGX Sparkについて公開された測定値を基に、記載されたソフトウェアバージョンでATOM上で再実行した結果です。
- 騒音
- このページに記載した騒音の評価は、Peter Falkingham氏のテストに基づいています。
- マシン全体の消費電力
- このページの電力値はGPU単体に対応しています。シリーズの次のガイドでは消費電力を詳しく説明します。
- 室温
- 掲載している温度は、マシンに内蔵されたセンサーから取得したものです。
- 二台のマシン間の接続
- 二つのQSFPポート(200 Gb/s)はテストしていません。
- その他のリファレンスと64 GB版
- 測定対象は128 GBのリファレンスATAGB10-9000です。
DGX OS、ファームウェア、または私たちのツールの新しいバージョンによって結果が変わった場合、このページを更新します。修正にはすべて日付を付けます。
#AI TOP ATOMが適している方
以下は、9000のリファレンス機での測定結果と、2026年10月8日の価格調査に基づいています。
- GB10の基準性能を、整った筐体で求める方
- 9000は、最大でも4.3 %の差で、DGX Sparkについて公開された速度を再現します。PCIe 5.0接続の4 TB SSDを読み取り13 GB/sで測定した結果です。
- …マシンを机の上に置いておく
- 一リットルに収まり、重さは1,2 kgで、前面はすっきりしています。アイドル時のGPU消費電力は約10 Wです。
- …チームまたはAIエージェントにサービスを提供する場合
- gpt-oss 120Bで16ユーザーを1時間、その後Llama 3.3 70Bで8ユーザーを二時間実行しました。速度は安定したままでした(変動は0,0 %および−0,6 %)し、スロットリングは一切ありませんでした。
- …チップを変えずに支払いを減らしたい場合
- 9001は、PCIe 4.0接続の4 TB SSDを搭載し、2026年10月8日にAORUS公式ショップで6,346.27 €と表示されていましたが、売り切れでした。一方、Amazon.frでは在庫がありました。同じチップと同じ128 GBを搭載しています。このページの調査結果は9000モデルを対象としています。
- …コンテキストを含めてもモデルの占有量が35 GB未満になる
- 2026年10月23日発売予定の64 GB版で十分なはずです(最初のガイドから算出した値で、このバージョンでは未測定)。入手可能になり、価格が判明するまでお待ちください。
- …複数のマシンを接続したい
- 二つのQSFPポート(200 Gb/s)はこの用途のために用意されています。GIGABYTEはケーブルを別売りしています。
#FAQ
AI TOP ATOMはNVIDIAのDGX Sparkと同じくらい高速ですか?+
ATOMとFounders Editionでは、具体的に何が変わるのでしょうか?+
AI TOP ATOMは長時間稼働すると遅くなるのでしょうか?+
9000、9001、9002のどれを選ぶべきでしょうか?+
64 GB版を待つべきでしょうか?+
ご意見、誤りのご指摘、補足はありますか?ぜひお知らせください。皆さんにとってより良いガイドにするために役立ちます。