GB10 でのローカルファインチューニング:測定結果と 方法
GIGABYTE AI TOP ATOM(NVIDIA GB10 チップ、128 GB)では、特定のタスク向けに学習させた小規模モデルが、そのタスクにおいて非常に大規模なモデルを上回ることがあります。85 分の LoRA 学習により、Qwen3-8B は未知の架空の請求書 200 件のうち 95 % からエラーなくデータを抽出できました。gpt-oss 120B では 62.5 %、学習なしでは 26 % です。Unsloth による QLoRA もメモリに収まり、70B で 41 GB、gpt-oss 120B で 64 GB です。学習にかかった電気代は GPU 側で 1.5 サンチームでした。
ファインチューニングとは、既存のモデルに追加の学習を行い、特定のタスクをこなせるようにすることです。128 GBのユニファイドメモリがあれば、GB10マシンでサーバーを借りることも、データをオンラインサービスに預けることもなく、手元で実行できます。このガイドでは、GIGABYTEから無償で提供されたAI TOP ATOMで測定した一連の事例として、請求書のデータをJSONで抽出する作業を取り上げます。また、Unslothを使用したgpt-oss 120BまでのQLoRA(4ビットに圧縮したモデルに同じ手法を適用するもの)の測定結果と、私たちの試験で使用したコマンドも掲載しています。
#実際のケース:請求書を読み取って JSON を生成する
このタスクは、小規模な企業でよく発生するものです。請求書、見積書、またはクレジットノートのテキストから、モデルは JSON、つまりソフトウェアが読み取れる構造化データを返す必要があります。このデータには採点対象のフィールドが 31 個あります。ドキュメントの種類、番号、日付、発行者、顧客、商品明細、割引、合計、TVA、前払金、IBAN です。このタスクを選んだのは、別のモデルによる判定を必要とせず、回答をフィールドごとに検証できるからです。
文書は架空のものです。小さなプログラムで 12 種類のレイアウト、つまり 12 種類の請求書の形式を、架空の企業名とともに生成しました。乱数は固定の「シード」で設定されているため、実行するたびに同じ文書が生成されます。学習には 10 種類のレイアウトにわたる 2,000 件の文書を使用します。
評価には未見のドキュメント 200 件を使います。内訳は、同じ 10 種類のレイアウトのものが 100 件、学習に含まれない 2 種類のレイアウトのものが 100 件です。後者の 100 件により、モデルがタスクを理解したのか、形式を覚えただけなのかがわかります。
モデルが受け取るのは文書のテキストであり、画像やPDFではありません。以下は、最初のテスト文書である四行の架空の貸方票に対する、学習済みモデルの回答の抜粋です。
#手法:LoRA、一エポック、85分
私たちの経験とガイド付きルートを活かして、ローカルアシスタントを作り、AIを毎日の作業に取り入れましょう。
- 永久に利用できるオンラインスペース
- PDF + ファイル
- 30日間返金対応
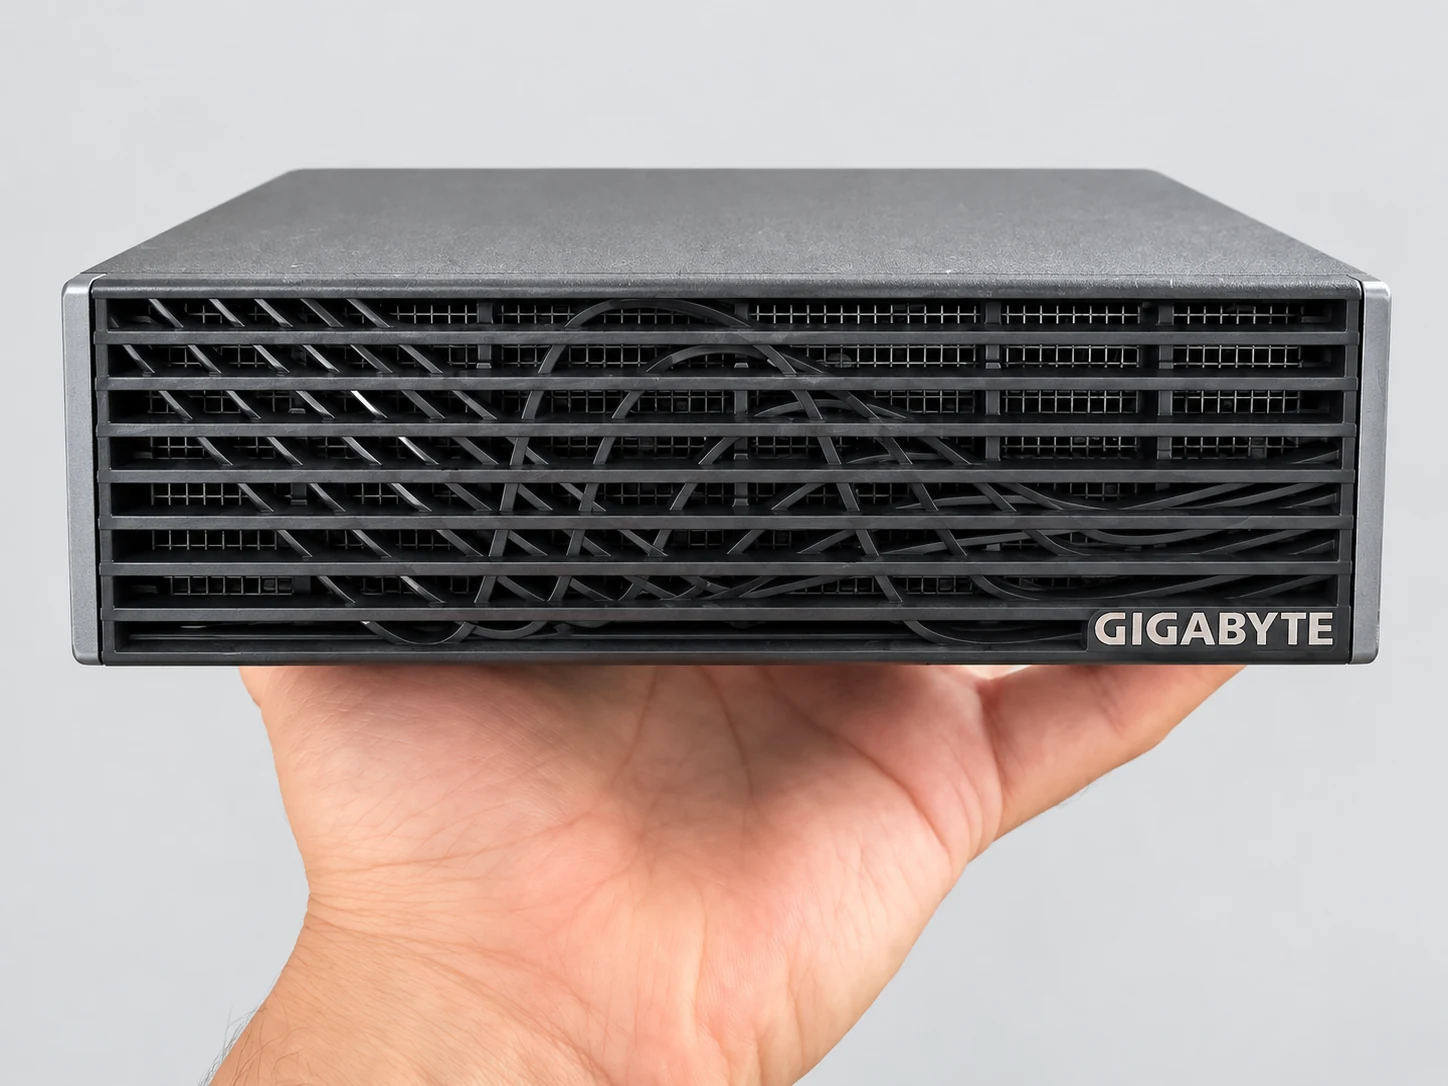
使用したマシンは GIGABYTE AI TOP ATOM(型番 ATAGB10-9000)です。チップは NVIDIA GB10、ユニファイドメモリは 128 GB、SSD は PCIe 5.0 接続の 4 TB で、OS は DGX OS 7.5.0(ドライバー 580.159.03、CUDA 13.0)です。ソフトウェアには、NVIDIA の PyTorch コンテナ(バージョン 26.03、PyTorch 2.11 を含む)、LoRA 用に PEFT 0.21.2、QLoRA 用に Unsloth 2026.10.1、サービング用に NVIDIA の vLLM 26.09 コンテナ(vLLM 0.29.0)を使用しています。マシンの詳細と 13 モデルの速度については、本シリーズの最初のガイドで解説しています。
LoRA(Low-Rank Adaptation)は、元のモデルには手を加えず、その層に追加した小さな行列を学習します。学習の成果物はアダプターと呼ばれる小さなファイルで、モデルと一緒に読み込んで使用します。ここで学習するパラメータは 4,360 万個で、Qwen3-8B の 80 億個に対してごくわずかです。
このガイドには三つの用語が繰り返し登場します。学習ステップでは、4文書からなるバッチを一つ処理します。エポックは、2,000件の文書全体を一巡することです。損失は、モデルが書いた回答と期待される回答との差を測る指標で、低いほど良好です。
- モデル
- bf16(16 ビットの数値形式)の Qwen3-8B、圧縮なし。
- LoRA
- ランク 16、alpha 32(スケール係数)、dropout 0.05(過学習を抑えるため、各ステップで値のごく一部をランダムに無視します)。対象は各層の 7 つの射影、つまり 7 つの重み行列(q、k、v、o、gate、up、down)です。ランクは追加する行列のサイズを決定します。
- 所要時間
- 1エポック:4文書のステップを500回。
- 学習率
- 1e-4、つまり 0.0001 で、30 ステップかけて徐々に上昇させた後、コサイン減衰させます。
- Lots
- 2,000 件の文書を長さで並べ替えてバッチを作成し、固定シードでバッチの順序をシャッフルします。各バッチには長さの近い文書が入るため、無駄なパディングが減り、学習が速くなります。
- Perte
- JSON 応答のみで計算します。プロンプトとドキュメントはマスクされるため、モデルはドキュメントを書き写すのではなく、応答を書くことを学習します。
- 長さ
- 最大 2,304 トークン。最も長いドキュメントは 2,204 トークン、平均は 1,143 トークンで、切り詰められるものはありません。
- メモリ
- gradient checkpointingが有効になっています。モデルはすべての結果をメモリに保持する代わりに、一部の結果を再計算します。
これらの設定は、200件のテスト文書でのあらゆる評価に先立ち、2026年10月7日付のプロトコル補遺で決定されました。プロトコルは最初の測定の前に確定しており、手法、日付入りの補遺一覧、表のデータは私たちの手法ページで公開しています。このガイドのメモリ容量は、Linuxの表示と同じくGB単位です(1 GB = 1,024 MB)。
すべての作業は NVIDIA の PyTorch コンテナ(バージョン 26.03)内で行います。その中の Python 環境に transformers と PEFT のライブラリをインストールします。以下のパスは簡略化していますが、オプションは私たちのテストで使用したものです。
#結果:完全に正しい文書が 95 %
スコアは、モデルが出力した値と期待される値を、正規化したうえでフィールドごとに比較して算出します。すべてのフィールドが正確なドキュメントを「完全」とします。三つのモデルには同じプロンプトを、温度 0(回答が最も安定する設定)で、vLLM 26.09 を介して 16 ドキュメントずつ同時に与えます。Qwen3-8B では思考を無効にしています。gpt-oss 120B では推論エフォートを「低」に設定しています。
| モデル | 正確なフィールド | 完全正解の文書 | 完全正解、既知のレイアウト | 完全正解、新しいレイアウト | 200 件の文書の処理時間 |
|---|---|---|---|---|---|
| 学習なしの Qwen3-8B | 84,8 % | 26,0 % | 27 % | 25 % | 686 s |
| 学習なしの gpt-oss 120B | 97,5 % | 62,5 % | 58 % | 67 % | 991 s |
| Qwen3-8B + LoRA (85 分) | 99,2 % | 95,0 % | 96 % | 94 % | 524 s |
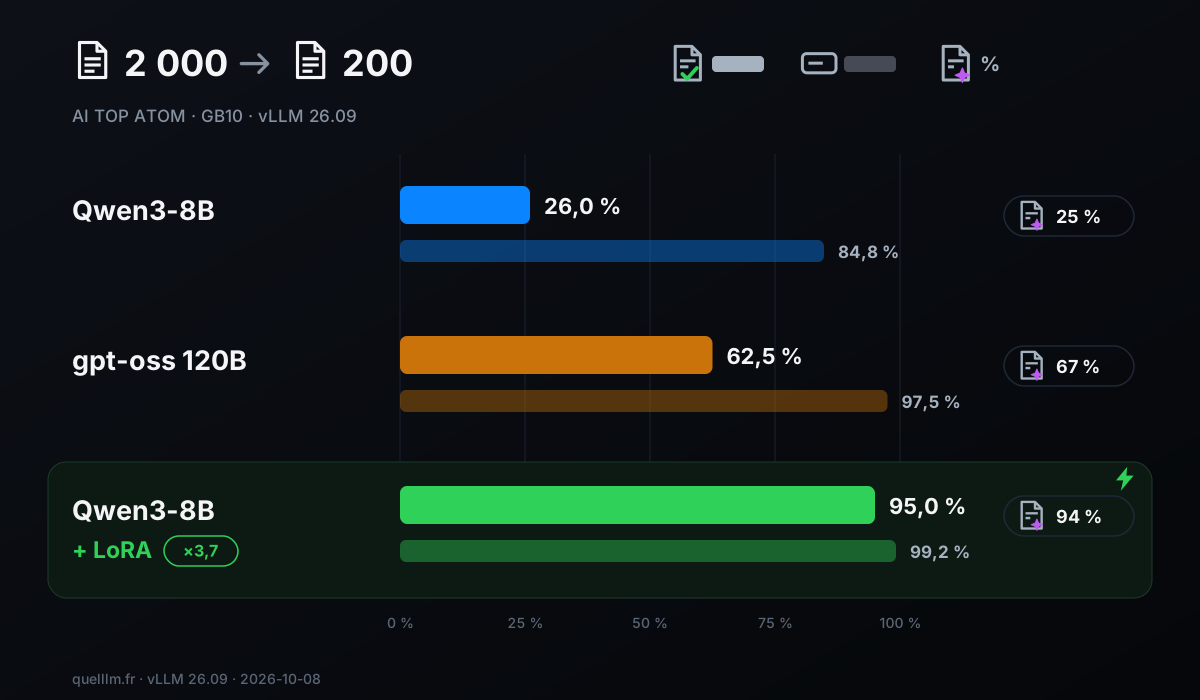
学習済みモデルの完全正解率は 95.0 % で、学習なしの同じモデルの 26.0 % を 69 ポイント上回り、エラーのない文書は 3.7 倍に増えました。パラメータ数 1,170 億の gpt-oss 120B(62.5 %)も上回っています。処理速度も最も速く、200 件の文書を 524 秒で処理しました。gpt-oss 120B は 991 秒、学習なしの Qwen3-8B は 686 秒です。応答も短くなり、出力トークン数は gpt-oss 120B の 160,702 に対して 98,847 です。
未見のレイアウトのドキュメント 100 件において、学習済みモデルは完全なドキュメント 94 %、正確なフィールド 98.5 % を維持しています。既知のレイアウトではそれぞれ 96 % と 99.9 % です。完全なドキュメントの差は 2 ポイント(96 % に対して 94 %)であり、アダプターの効果は学習中に見た形式に限定されません。
フィールド別の内訳を見ると、学習によって何が改善されたかがわかります。31 のフィールドはいずれも文書の 97.5 % 以上で正確であり、そのうち 18 フィールドは文書の 100 % で正確です。学習なしの場合、10 のフィールドは正解率が 49.5 % から 61.5 % にとどまります。該当するのは金額(値引き、合計、TVA、前払金、支払額)と明細行(数量、単価、TVA 税率、金額)です。学習後は、これら 10 のフィールドの正解率が 98 % から 100 % になります。
三つのモデルはいずれも、100% のケースで有効な JSON を返し、100% のドキュメントで正しい行数を検出します。したがって差が出るのは応答の形式ではなく、フィールドの値です。
#かかるコスト:時間、メモリ、電気
| 測定 | 値 |
|---|---|
| 学習時間 | 5,090 秒、つまり 85 分(ステップあたり 10.2 秒) |
| PyTorch で測定した GPU メモリのピーク | 33.3 GB |
| GPU の電力 (平均とピーク) | 53.0 W と 62.7 W |
| GPU温度、平均と最大 | 65 °C と 77 °C |
| GPUが報告したスロットリング | 5,206 件の測定値のうち該当なし |
| 学習時のGPUエネルギー(計測時間87分、読み込みを含む) | 76.7 Wh |
| EDF Tarif Bleu Baseの料金によるコスト(税込、kWhあたり20.01サンチーム) | 1.5 サンチーム |
| 学習済みモデルでテストドキュメント 200 件を読み取る際の GPU のエネルギー | 約 6 Wh |
これらの数値はGPU単体に関するもので、チップが報告した値です。NVIDIAによると、nvidia-smiに表示される電力はGPU単体のものです。プロセッサー、メモリ、SSD、電源は含まれていません。料金は、2026年8月1日時点で適用される料金表における、EDFのoption Base(6 kVA)のものです。基本料金は含まれていません。
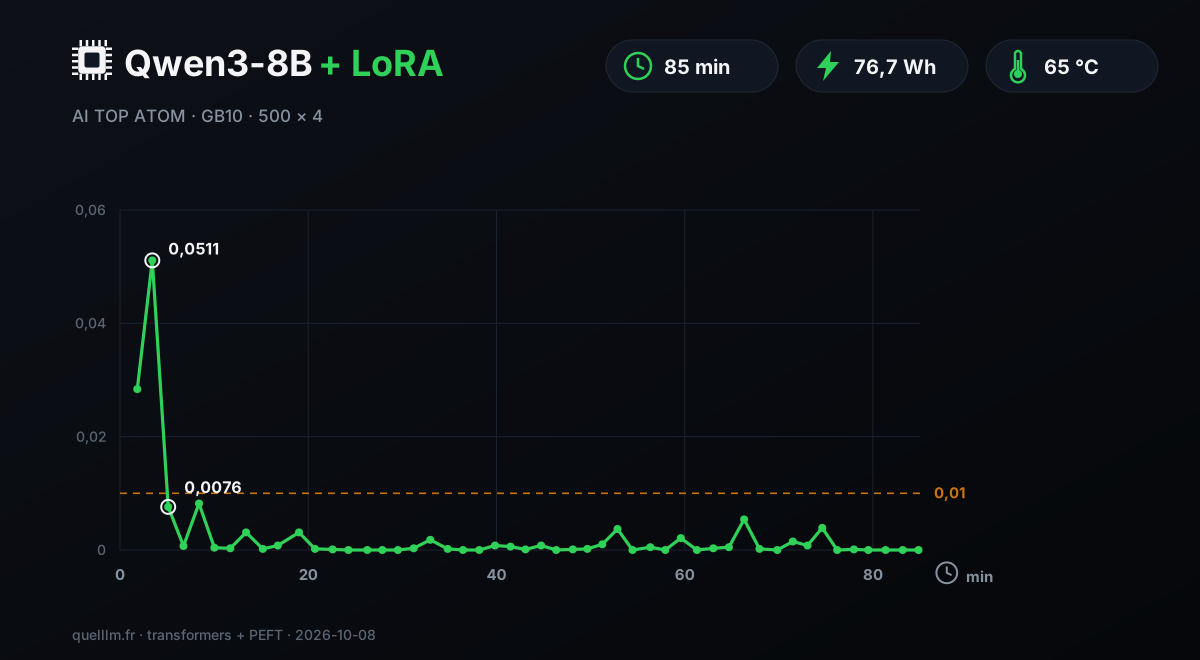
曲線の各点は 4 件のドキュメントからなる単一のバッチから得たものなので、値は記録ごとに変動します。損失はステップ 30 で、学習開始から 5 分後に 0.01 を下回り、以降の記録で 0.0082 を超えるものはありません。このケースでは、一エポックだけで完全正解のドキュメント 95% に到達しました。
#Unsloth による QLoRA:70B モデルと gpt-oss 120B を同じマシンで
QLoRAは、モデルの重みを4ビットに圧縮してメモリ使用量を大幅に削減し、その上でLoRAアダプターを学習します。マシンを買い替えずに大規模なモデルを特化させるための方法です。私たちは、開発元によればファインチューニングを軽量化・高速化するというオープンソースツール、Unslothを使用しました。
NVIDIA は、NVIDIA の PyTorch コンテナ(バージョン 25.11)で DGX Spark 上の Unsloth を利用する公式ガイドを公開しており、パラメータ数 10 億から 700 億のモデルに対応した PyTorch の公式ファインチューニング環境も提供しています。Unsloth は gpt-oss 120B の 4 ビット QLoRA に必要なメモリを約 68 GB としています。当社の測定ではピークが 64.4 GB で、同程度の値でした。
Llama 3.3 70B と gpt-oss 120B の二つのモデルについて、速度とメモリを測定しました。どちらも Unsloth が公開している 4 ビット形式です。各試行は 40 ステップで構成され、ウォームアップにあたる最初の 10 ステップは平均に含めていません。
シーケンスは 1,024 トークンで、バッチサイズは 1、LoRA のランクは 16 です。これらのステップは私たちのプロトコルの基準テキストで実行したもので、スループットとメモリを測定するものであり、有用なモデルを生成するものではありません。
| モデル | Chargement | モデルのメモリ | GPU メモリのピーク | ステップあたりの秒数 | 毎秒トークン数 | 学習対象パラメータ数 |
|---|---|---|---|---|---|---|
| Llama 3.3 70B(QLoRA、4ビット) | 247 s | 37.6 GB | 41.3 GB | 9,39 | 109 | 207百万(7 つの射影) |
| gpt-oss 120B(4 ビット QLoRA) | 397 s | 58.5 GB | 64.4 GB | 6,35 | 161 | 1,190 万(4 つのアテンション射影) |
| Qwen3-8B(LoRA bf16) | — | — | 63.4 GB | 5,42 | 756 | 4,360万(7つの射影) |
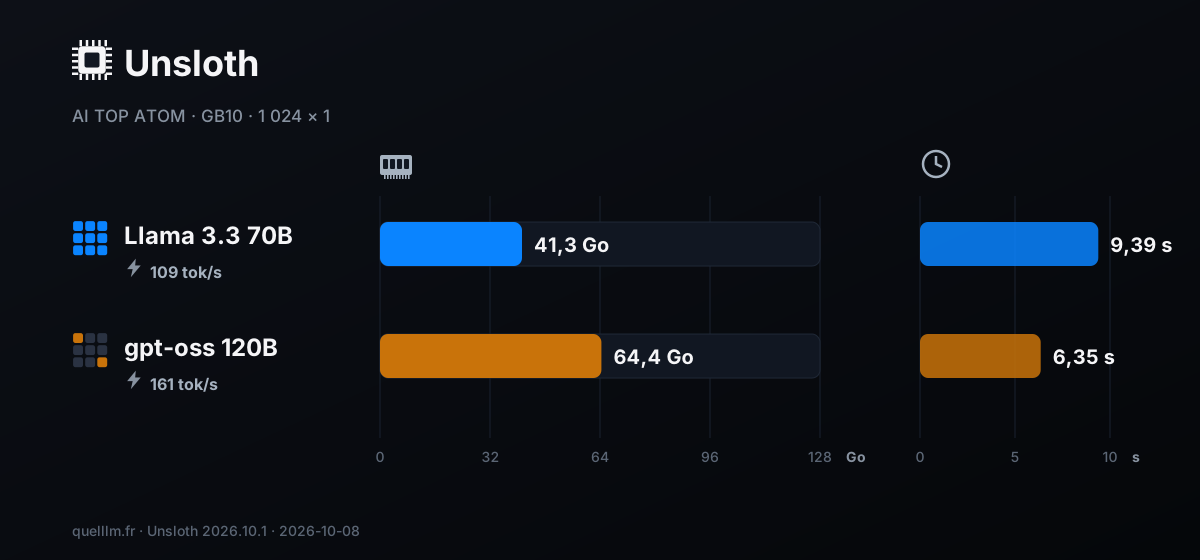
70B の学習時のピークは 41.3 GB で、システムが認識する 121.7 GB の約三分の一です。gpt-oss 120B では 64.4 GB が必要です。どちらの場合も、他のサービスを動かす余裕が残ります。注目すべき点として、gpt-oss 120B はモデルが大きいにもかかわらず、ステップあたりの処理が 70B より高速です(6.35 秒に対して 9.39 秒)。
これはMoE(専門家混合)モデルです。各トークンの処理では、117B個のパラメーターのうち5.1個(単位は同じ)だけを使用します。このモデルでは、attentionの4つの行列(q、k、v、o)だけを学習させており、対象は11.9M個のパラメーターです。70Bモデルには7つの射影にLoRAを適用し、207M個のパラメーターを学習させます。
計画の目安として、当社の測定値をもとに計算した結果を示します。1024 トークンのステップを 1000 回、つまり約百万トークンを処理する場合、70B では 2 時間 36 分、gpt-oss 120B では 1 時間 46 分かかる見込みです。これらの所要時間は、お使いのデータセットで確認してください。70B の QLoRA では、モデルの読み込みを含めて GPU を 10.8 分間使用し、GPU 側の消費電力は 8.9 Wh でした。
Unsloth 2026.10.1は、上記と同じPython環境に、同じPyTorchコンテナ内でインストールされています。手順を追ったインストール方法については、ページ末尾にリンクを掲載しているNVIDIAの公式ガイドとUnslothのドキュメントに従ってください。
#学習済みモデルを vLLM でサービングする
vLLM は、複数のユーザーに同時に応答できるよう設計されたオープンソースのサーバーです。ここでは NVIDIA が提供するコンテナで使用しています。vLLM は元のモデルを読み込み、そこにアダプターを追加します。すると API は二つの名前を公開します。アダプターなしの Qwen3-8B と、アダプターありの factures です。両者を同じサーバー上で評価したため、公平な比較になっています。
16 件のドキュメントを同時に送信すると、200 件の請求書は 524 秒で処理されます。このペースであれば、1,000 件の請求書にかかる時間は約 44 分です。これは私たちの測定値から算出した値です。ポートはローカルアドレス 127.0.0.1 にバインドされています。サービスをネットワークに公開するには、API キーを追加してください。この手順は vLLM の本番運用ガイドで詳しく解説しています。
#このケースをお手元の環境で五つのステップで再現する
- 01サンプルを準備しますドキュメントのテキストと、期待される JSON 応答のペアを集めます。プロンプトは一つだけ作成し、学習と評価で同じものを使います。私たちは 2,000 件のサンプルを使用しましたが、最小しきい値は測定していません。
- 02テストセットを取り分けます一部のドキュメントを取り分けておき、モデルには一切見せないでください。そこに学習に含まれないレイアウトをいくつか加えると、モデルが汎化できているかを確認できます。
- 03一エポック学習しますサンプルを長さで並べ替えてバッチを作成し、応答部分のみで損失を計算して、損失曲線を監視します。
- 04学習の前後で採点します同じプロンプトで、元のモデルと学習済みモデルをフィールドごとに採点します。学習なしの大きなモデルも採点してください。これが最も有用な比較です。
- 05vLLM で提供しますenable-lora オプションでアダプターを読み込み、お使いのソフトウェアを API に接続します。
#ファインチューニング、RAG、より良いプロンプト: どれを選ぶべきでしょうか?
まずはプロンプトから始めてください。無料ですぐに試せます。モデルがドキュメント内の事実を見つける必要がある場合は、RAG のほうが適しています。RAG は、回答する前にまずお使いのファイルを検索するアシスタントです。
ファインチューニングが適しているのは、タスクが繰り返し発生し、出力形式を安定させる必要があり、サンプルが手元にある場合です。請求書の読み取りは、この三つの条件をすべて満たしています。二つのアプローチは同じマシン上で組み合わせることができます。本シリーズの別のガイドでは、RAG アシスタントの完全な例を紹介しています。
#私たちの測定の限界
- 架空の文書
- 私たちの請求書は、12種類のレイアウトを使ってスクリプトで生成したものです。スキャンまたは撮影された実際の文書では、まずテキストの読み取り(OCR)が必要であり、異なる結果になる可能性があります。
- 学習は一回のみ
- 学習したアダプターは一つだけで、各モデルの評価は温度0で一度ずつ行いました。学習ごとのばらつきは測定しておらず、より長い学習との比較も行っていません。
- gpt-oss 120B
- このモデルは、推論エフォートを低く設定した状態で評価しています。別の設定にするとスコアが変わる可能性があります。
- QLoRA
- QLoRAの測定は速度とメモリを対象とし、40ステップで行いました。学習済みの70Bモデルや120Bモデルの品質は評価していません。
- エネルギー
- GPU 単体のみが対象です。
- 対象外
- モデルの全パラメータの学習や、接続した複数台のマシンの使用については測定していません。
更新と修正:Unsloth、vLLM、DGX OS の新しいバージョンによってこれらの結果が変わる場合は、このページを改訂します。修正にはそれぞれ日付を記載します。
#ATOMが適している人
- 小規模モデルを自社の文書に特化させたい中小企業や事務所
- 85 分の学習と GPU 側で 1.5 サンチームの電気代で、架空の請求書データセットにおいて完全に正しく処理できた請求書の割合が 26 % から 95 % に向上しました。第三者には文書を一件も送信していません。
- プロトタイプを構築する開発者やデータチーム
- LoRAのQwen3-8B、QLoRAの70Bまたはgpt-oss 120B:これら三つはいずれも同じマシンで動作し、GPUメモリのピークは33~64 GBです。
- 学習、評価、サービングを一か所で行いたいチーム
- 同じマシンで、アダプターの学習、三つのモデルの評価、vLLMによる回答の提供を行いました。
- サーバールームのないオフィス
- 容量一リットルの筐体(150 × 150 × 50.5 mm、1.2 kg)で、240 W の USB-C アダプターから給電します。
プラットフォームとメーカーを分けて考えましょう。学習速度の大部分を決めるのは、NVIDIA GB10 チップ、273 GB/s の 128 GB ユニファイドメモリ、CUDA、DGX OS 7.5.0 です。推論については、私たちの測定値と DGX Spark の公表値との差は最大でも 4.3 % です。本ガイドの学習はすべて AI TOP ATOM で実施しました。
GIGABYTE が提供するのは、筐体と二基のファンによる冷却機構です。学習を記録した 87 分間、GPU 側の平均 53 W で、温度は平均 65 °C、最高 77 °C にとどまり、スロットリングは一度も報告されませんでした。
2026年10月8日に確認したATAGB10-9001(128 GB、PCIe 4.0接続の4 TB SSD)の価格:AORUS公式ストアでは税込6,346.27 €で、在庫切れでした。Amazon.frでは在庫がありました。私たちが測定したのは、SSDがPCIe 5.0接続のATAGB10-9000です。GB10の価格は毎週変動するため、購入前にご確認ください。
#FAQ
パラメーター数 80 億のモデルを GB10 でファインチューニングするには、どのくらい時間がかかりますか?+
128 GB で 70B モデルや gpt-oss 120B をファインチューニングできますか?+
小さな学習済みモデルが、大きなモデルを本当に上回ることはあるのでしょうか?+
ファインチューニングの電気代はいくらですか?+
学習が終わったら、アダプターをどのように使えばよいですか?+
ファインチューニングには ATOM の 128 GB 版が必要ですか?+
ご意見、誤りのご指摘、補足はありますか?ぜひお知らせください。皆さんにとってより良いガイドにするために役立ちます。