GB10、Ryzen AI Max+ 395、Mac: どれが最速?
同じエンジン(llama.cpp)で比較すると、NVIDIA GB10チップを搭載したAI TOP ATOMは、プロンプトの読み込みがRyzen AI Max+ 395より2.1~2.8倍速く、公開されている基準モデルではMac M5 Maxより23 %速くなります。書き出しではRyzenと同等の水準です(モデルによって4~15 %上回ります)。Mac M5 Maxは小規模な密モデルでの書き出しが約二倍速く、119.9対59.4 tok/s(1秒あたりのトークン数)です。
ローカルAI向けに128 GBのメモリを備えたマシンには、三つの系統があります。GIGABYTEのAI TOP ATOMもその一つであるNVIDIAのGB10、AMDのRyzen AI Max+ 395(コードネームStrix Halo)、そしてAppleのMac M5 Maxです。GIGABYTEから無償で提供されたAI TOP ATOMを、他の二機種について公開されている測定と同じコマンドで測定し、ソフトウェアのバージョンと日付も明記しています。それぞれが得意とする分野と、用途ごとにどれを購入すべきかを紹介します。
#三台のマシンをどのように比較したのでしょうか?
Ryzen AI Max+ 395 と Mac の公開ベンチマークを ATOM の測定値と比較するため、既存の公開測定とまったく同じ形式を採用しました。最初のテストでは、マシンに 512 トークン(トークンとは単語の断片です)を読み込ませ、次に 128 トークンを書き出させます(llama-bench における「pp512」と「tg128」です。llama-bench は、ローカルモデル向けに広く使われているオープンソースのエンジン llama.cpp の測定ツールです)。
このテストは、Mac M5 Max については llama.cpp のディスカッション No. 4167 で公開され、Ryzen AI Max+ 395 と 128 GB を搭載した Framework Desktop については独立したコントリビューターである kyuz0 氏によって公開されています。二つ目のテストは、すでに 32,768 トークンがメモリ上にある状態での速度を測定するものです。これは llama.cpp のディスカッション No. 16578 のテストで、kyuz0 氏は Ryzen についてもこれを公開しています。
当方の測定プロトコルは、最初の測定より前の2026年10月6日13時30分に確定しました。同日23時45分の追補で、この比較形式を追加しました。
512トークンの読み込みと128トークンの書き出しの測定は、10月7日22時38分に実施しました。条件は、モデルごとに五回の繰り返し、llama.cpp build 11430、kyuz0 の測定と同様に高速アテンション(Flash Attention)を有効化、ほかの処理を実行していないマシンです。32,768トークンでの測定は10月6日に実施しました。測定手法、ファイルのハッシュ値、表のデータは手法ページで公開しています。
速度はトークン毎秒(tok/s)で表しています。トークンとは単語の断片で、フランス語ではおよそ単語の三分の二に相当します。メモリ容量は GB 単位です(Linux の表示と同様に 1 GB = 1,024 MB)。GB/s 単位のメモリ帯域はメーカーの公表値で、十進単位です。ATOM で使用したコマンドは次のとおりです:
注意点:ビルドとは llama.cpp のバージョン番号のことで、三台のマシンは同じビルドを使用していません。Ryzen は 2026 年 5 月にビルド b9187 または b9193 で、Mac は 8 月に b10621 で、ATOM は 10 月に b11430 で測定されています。
より新しいビルドのほうが高速になる場合があります。公正を期すため、32,768トークンのテストについては、Ryzen で使われたビルドより古い2026年2月の build 7941 での当方の数値も掲載しています(この形式での Mac の公開測定値はありません)。
#128 GBの三台のマシン:何が違うのか?
私たちの経験とガイド付きルートを活かして、Macに合ったツールを選び、AIを毎日の作業に取り入れましょう。
- 永久に利用できるオンラインスペース
- PDF + ファイル
- 30日間返金対応
NVIDIA の GB10 は、20 基の Arm コアと Blackwell GPU を 128 GB のユニファイドメモリ(CPU と GPU で共有)で結び、その帯域幅は公称 273 GB/s です。AMD の Ryzen AI Max+ 395(コードネーム Strix Halo)も CPU と GPU で 128 GB を共有し、理論値で約 256 GB/s です。Apple の M5 Max は最大 128 GB、614 GB/s で、40 コアの GPU を備えます。
| マシン | チップ | メモリ | 帯域幅 |
|---|---|---|---|
| AI TOP ATOM(GIGABYTE) | NVIDIA GB10:20 基の Arm コアと Blackwell GPU | 128 GB LPDDR5x | 273 GB/s |
| Ryzen AI Max+ 395(Framework Desktopで公開された数値) | AMD Strix Halo | 128 GB LPDDR5x | 約256 GB/s(理論値) |
| Mac M5 Max | Apple M5 Max:40コア GPU | 最大128 GB | 614 GB/s |
トークンを一つ書き出すたびに、チップはモデルのアクティブな重み(その時点で使用されるパラメーター)をメモリから読み直します。そのため書き出し速度はメモリ帯域幅に左右され、一度に多くのトークンを処理する読み込み速度は GPU の演算性能に左右されます。
GB10とRyzenはメモリ帯域幅が近く、書き出し速度も近い値になります。M5 MaxはATOMの2.25倍の帯域幅(614対273 GB/s)を備えており、公開されている唯一の密モデルであるllama 7Bでは、書き出しが約二倍速くなります。
私たちの知る限り、128 GBのGB10搭載マシンはすべて同じNVIDIAチップを採用しています。したがって、本ガイドに掲載している速度はプラットフォームとしての速度です。GIGABYTEが独自に加えているのは、容量一リットル(1.2 kg)の筐体、冷却、仕上げ、そして販売モデルのラインナップです。
当サイトのユニットがこのプラットフォーム本来の速度を出していることを確認するため、llama.cppプロジェクトがNVIDIAのDGX Spark(このプラットフォームのリファレンスマシン、ビルド7941、2026年2月)について公開している表を再現しました。六つのモデル、60の測定点において、読み込みは中央値で+0.3%(−1.8%〜+2.3%)、生成は中央値で−2.8%(−4.3%〜−0.3%)でした。両マシンは同等の水準です。
#最も速く読み込むのはどれ?
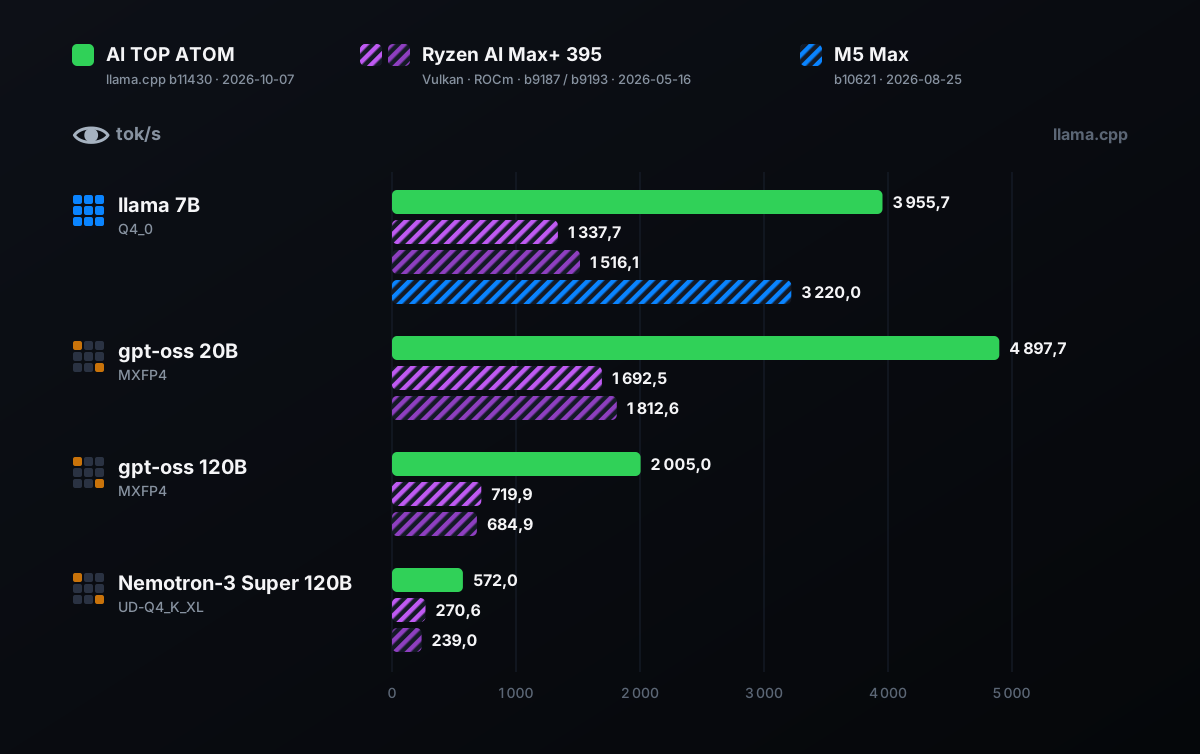
読み込みは ATOM の強みです。表には、厳密に比較できた四つのモデル、つまり各マシンで同じモデル・同じ量子化を使用したものを掲載しています。「llama 7B」は 70 億パラメーターの Llama 2 を指し、これらの公開データにおける基準モデルです。これは密モデル(トークンごとにすべてのパラメーターを使用)であるのに対し、他の三つは MoE モデル(その一部のみを有効化)です。
| モデル | AI TOP ATOM | Ryzen、Vulkan | Ryzen、ROCm | Mac M5 Max | ATOM / Ryzen最高値 |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 3 955,7 | 1 337,7 | 1 516,1 | 3 220,0 | × 2,6 |
| gpt-oss 20B(MXFP4) | 4 897,7 | 1 692,5 | 1 812,6 | — | × 2,7 |
| gpt-oss 120B(MXFP4) | 2 005,0 | 719,9 | 684,9 | — | × 2,8 |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 572,0 | 270,6 | 239,0 | — | × 2,1 |
これら四つのモデルで、ATOMはRyzen AI Max+ 395の二つのソフトウェアスタックのうち速い方と比べて、2.1〜2.8倍速く読み込みます(VulkanとROCmは、AMDのGPUに計算させるための二つの方法です)。gpt-oss 120Bでは毎秒2,005トークンを読み込み、2,000トークン(約1,300語)のプロンプトを一秒で処理します。
Mac との比較では、llama-bench 形式で公開されている比較対象は一つしかありません。Apple チップに関する llama.cpp のディスカッション第4167号の基準モデルである、Q4_0 の llama 7B(Llama 2 の70億パラメータ版)です。このモデルで ATOM は毎秒3,955.7トークンを読み込み、M5 Max は3,220.0トークンです。ATOM が23%上回っています。
Ollama(モデルをローカルで実行するツール)を使い、約17,000トークンの文書で、本シリーズ最初のガイドではATOMがgpt-oss 120Bで1,816 tok/sを記録しました。一方、読者が測定したMacBook Pro M5 Maxは1,388 tok/sでした。テキストは近いものの同一ではありません(ATOMは16,850トークン、Macは16,689トークン)。ATOMが31%上回っています。
ATOMの読み込みがこれほど速いのはなぜでしょうか?読み込みは主に計算処理であり、GB10のBlackwell GPUはAI計算専用のコア(NVIDIAの「Tensorコア」)を備えています。五十ページのレポート、コードリポジトリ、あるいは応答のたびに履歴を読み直すエージェントにとって重要なのは、この指標です。
数値を読む際の注意点が二つあります。まず、ビルドが異なります(Macは10621、ATOMは11430)。23%の差はおおよその目安としてとらえてください。次に、最も小さい二つのモデル(llama 7Bとgpt-oss 20B)は、このテストが約十分の一秒しか続かないため、繰り返しごとに3〜5%ばらつきます。それでも、別々の二つの系列の平均値は1%以内で一致しています。llama 7Bでは3,955.7と3,920.2、gpt-oss 20Bでは4,897.7と4,905.2です。
#書き出しが最も速いのは?
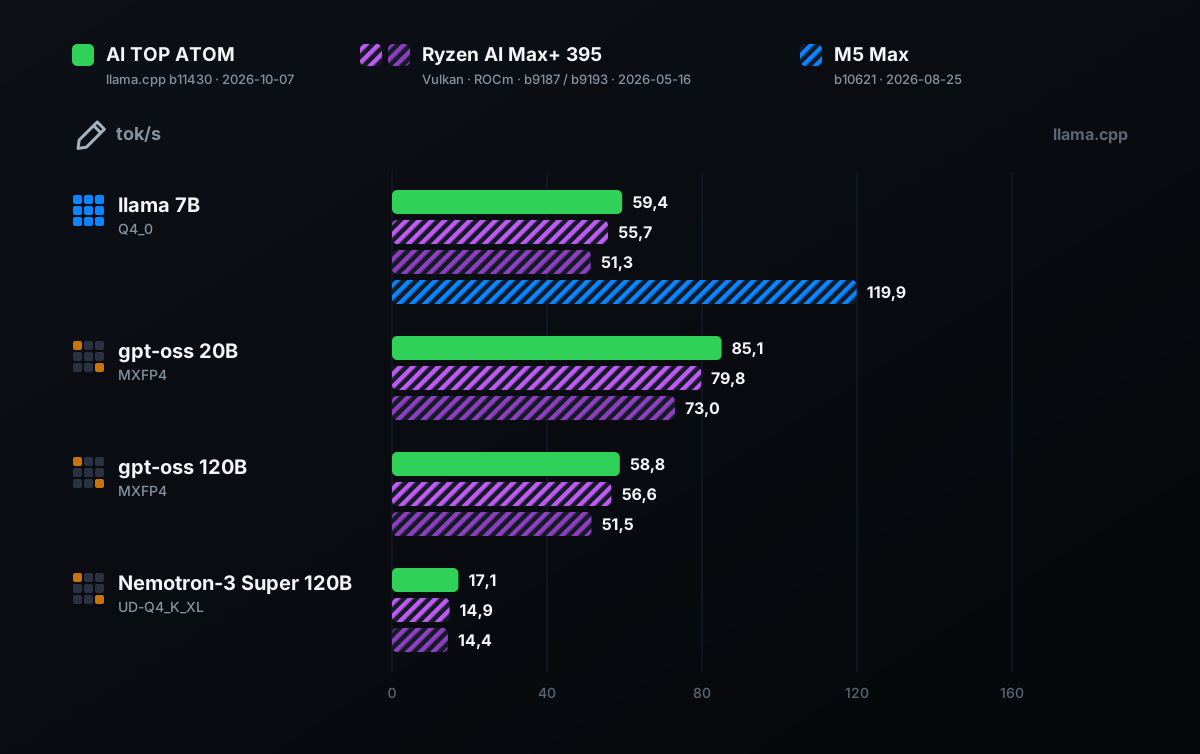
書き出しとは応答が表示されるペースです。これはメモリ帯域幅に比例し、帯域幅はマシンごとに異なります。
| モデル | AI TOP ATOM | Ryzen、Vulkan | Ryzen、ROCm | Mac M5 Max | ATOM / Ryzen最高値 |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 59,4 | 55,7 | 51,3 | 119,9 | +7 % |
| gpt-oss 20B(MXFP4) | 85,1 | 79,8 | 73,0 | — | +7 % |
| gpt-oss 120B(MXFP4) | 58,8 | 56,6 | 51,5 | — | +4 % |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 17,1 | 14,9 | 14,4 | — | +15 % |
Ryzen AI Max+ 395の最良のソフトウェアスタックと比べると、ATOMの書き出しは三つのモデルで4~7 %、Nemotron-3 Super 120Bでは15 %速くなります。これは近い水準と言えます。両者のメモリ帯域幅は近く、ビルドも異なるためです。
1170億パラメータのモデルであるgpt-oss 120Bで、ATOMは128トークンの生成において毎秒58.8トークン(最初のガイドでは32トークンで58.0)を出しており、会話には非常にスムーズです。Ryzenは最高でも56.6です。
書き出しは Mac M5 Max のほうが速く、小型の密モデルではおよそ二倍(毎秒119.9トークン対59.4トークン)です。これは、ATOM の2.25倍にあたる614 GB/s のメモリによるものです。
密なモデルでは、ソフトウェアによって生成を高速化できます。大きなモデルが一度にまとめて検証するトークンを小さな「ドラフト」モデルが提案する手法(投機的デコーディング)を使うと、ATOM 上の Llama 3.3 70B は、フランス語テキストで 4.7 トークン/秒から 12 トークン/秒に(8 語先読み)、コードでは最大 18.7 トークン/秒に(16 語先読み)向上します。つまり 2.6 倍から 4 倍の高速化です(llama-server b11430、ドラフトモデル Llama 3.2 1B、6日と2026年10月7日に測定)。この手法は他のマシンでも利用できますが、そちらでは測定していません。
#長い文書ではどうなりますか?
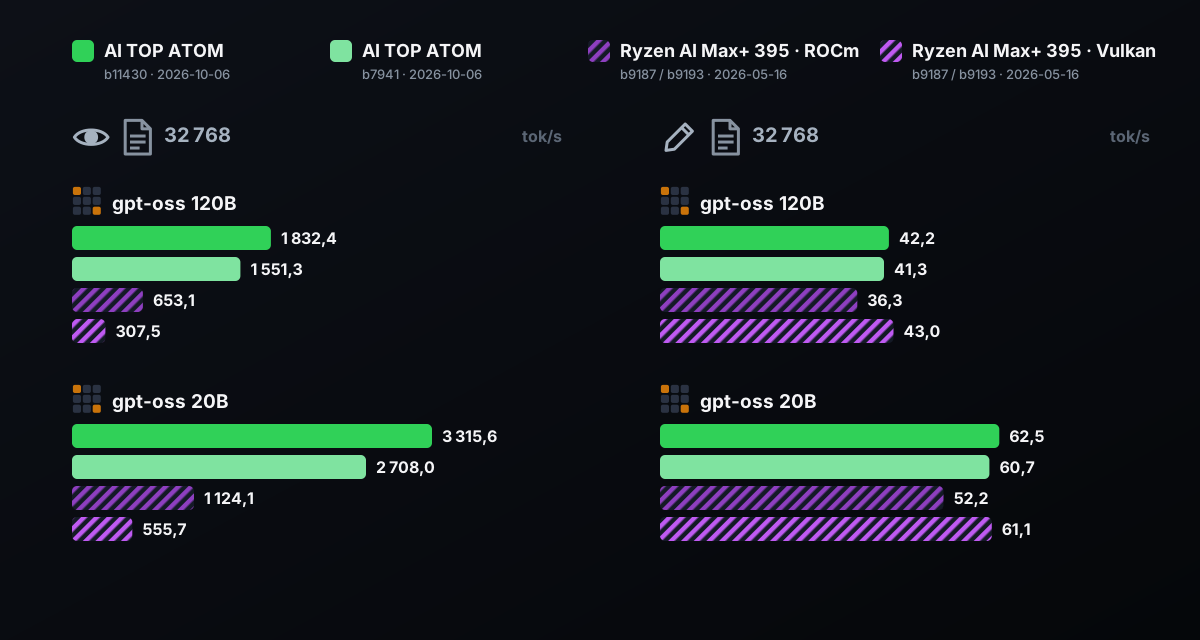
既存のテキストが長いほど、続きの処理は遅くなります。大規模コンテキストのテストでは、32,768トークン(約五十ページ分)がすでにメモリにある状態での読み込みと書き出しを測定します。表では、二つの gpt-oss モデルについて ATOM と Ryzen AI Max+ 395 を比較しており、ATOM は二つのビルドで測定しています。当方の知る限り、Mac について同じ形式で公開された測定値は存在しません。
| モデル | マシンとソフトウェアスタック | 32,768での読み込み | 32,768での生成 |
|---|---|---|---|
| gpt-oss 120B | AI TOP ATOM、ビルド11430 | 1 832,4 | 42,2 |
| gpt-oss 120B | AI TOP ATOM、ビルド7941 | 1 551,3 | 41,3 |
| gpt-oss 120B | Ryzen AI Max+ 395、ROCm | 653,1 | 36,3 |
| gpt-oss 120B | Ryzen AI Max+ 395、Vulkan | 307,5 | 43,0 |
| gpt-oss 20B | AI TOP ATOM、ビルド11430 | 3 315,6 | 62,5 |
| gpt-oss 20B | AI TOP ATOM、ビルド7941 | 2 708,0 | 60,7 |
| gpt-oss 20B | Ryzen AI Max+ 395、ROCm | 1 124,1 | 52,2 |
| gpt-oss 20B | Ryzen AI Max+ 395、Vulkan | 555,7 | 61,1 |
gpt-oss 120B では、コンテキスト長 32,768 トークンで ATOM の読み込み速度は毎秒 1,832 トークンです。これは ROCm 使用時の Ryzen AI Max+ 395(653)の 2.8 倍、Vulkan 使用時(308)の 6 倍の速さです。Ryzen のものより古いビルド 7941 でも、差は 2.4 倍と 5 倍を保っています。gpt-oss 20B とビルド 11430 では、差は 2.9 倍と 6.0 倍です。
32,768トークンでの書き出しでは、ATOM(gpt-oss 120B で42.2 tok/s)は Ryzen の最良のスタック(Vulkan で43.0)と同等で、もう一方のスタック(ROCm で36.3)を上回っています。つまり結果は単純です。長い文書の場合、AMD のマシンは最良のスタック(Vulkan で43.0)を使えば同じ速さで書き出せますが、読み込みには2.8〜6倍の時間がかかります。
実際の使用では、llama-server(llama.cppのサーバー)を使って、当サイトのATOMはgpt-oss 120Bで30,000トークンの文書を21.8秒で読み込み、その後毎秒42.8トークンで応答を生成します(本シリーズ最初のガイドでの測定)。
#複数ユーザーの場合はどうでしょうか?
複数の人や複数のエージェント(自律的に動作する AI プログラム)が同時にマシンに問い合わせる場合、vLLM のようなサーバーはそれらのリクエストをまとめ、すべてのリクエストに対してモデルの重みを一度だけ読み込みます。すると帯域幅だけがボトルネックではなくなり、GB10 の演算性能が効いてきます。
最初のガイドでは、gpt-oss 120B は一人のときの35.6 tok/s から、16人で合計160.3 tok/s となり、一人あたりでも10.2 tok/s を維持していました。gpt-oss 20B は合計で49.1から322.4 tok/s となり、一人あたり20.7 tok/s でした(vLLM 26.09、2026年10月6日)。
ピーク性能と同じくらい、持続性能も重要です。16ユーザーで1時間(リクエスト4,096トークン、応答512トークン)実行した間、gpt-oss 120Bは開始から終了まで合計124.8トークン/秒を維持しました。14の測定区間では122.6~128.1で、劣化は0.0 %、GPU温度は最高77 °C、スロットリングは一切ありませんでした。
Llama 3.3 70B を NVFP4(NVIDIA の圧縮フォーマット)で8ユーザー同時に2時間動かしたところ、合計スループットは毎秒38.7トークンから38.5トークンへ変化しました(−0.6%)。
StorageReview は、Ryzen AI Max ファミリーに属する AMD Ryzen AI Halo マシンと DGX Spark を対象に、vLLM で同種の負荷を測定しました。AMD のマシンは、高い同時実行数のシナリオの大半で2〜4倍の差をつけられ、gpt-oss 120B を用いた読み込み負荷の高いテストでは最大8.8倍の差がありました。DGX Spark は ATOM と同じチップを搭載しています。これらの Ryzen の数値は StorageReview のテストによるものです。
#CUDAによって、特に学習面では何が変わりますか?
CUDAは、NVIDIAが自社GPUで計算を行うためのソフトウェアプラットフォームです。ATOMでは、DGX OS 7.5.0(CUDA 13.0、ドライバー580.159.03)上で、このチップ向けにコンパイルしたllama.cpp、NVIDIAが提供するコンテナ内のvLLM、そしてUnslothが当サイトの環境で動作しました。当サイトの知る限り、多くのAIツールはまずCUDA向けに書かれています。これはモデルのサービス提供にも学習にも強みとなります。

トレーニングについては、NVIDIA はこのプラットフォームで最大700億パラメータのモデルをファインチューニングできるとしています。当方では Unsloth 2026.10.1 と QLoRA 手法(重みを4ビットに圧縮した状態で行うファインチューニング)を使い、シーケンス長1,024トークン、40ステップ(最初の10ステップはウォームアップ)の条件で二つのケースを測定しました。
Llama 3.3 70B は、ピーク時に 41.3 GB の GPU メモリを必要とし、各ステップあたり 9.4 秒かかります。gpt-oss 120B は 64.4 GB を必要とし、各ステップあたり 6.4 秒です。したがって、このサイズのモデルは二つとも、余裕を持って ATOM のメモリ内でトレーニングできます。
具体例:Qwen3-8Bに対してLoRA方式の軽量なファインチューニング(一エポック、2,000サンプル)を85分間行ったところ、未見の200件の書類を厳格に採点した結果、誤りなく抽出できた請求書の割合が26.0 %から95.0 %に向上しました。これは学習なしのgpt-oss 120B(62.5 %)を上回る結果です。請求書は当社が生成した架空のものです。手法の詳細は、本シリーズのファインチューニングに関するガイドで説明しています。
さらに、二つの QSFP ポート(GIGABYTE によれば200 Gb/s の ConnectX-7 ネットワークカード)と一つの 10 GbE ポートを備えています。GIGABYTE によると、最大四台の GB10 マシンをクラスタとして接続できますが、当方ではこの構成をテストしていません。
#これら三台のマシンの価格はいくらですか?
2026年10月8日にフランスの販売店ページで確認した税込価格です。GB10 の価格は毎週変動するため、購入前にご確認ください。
| マシン | 構成 | 税込価格 | Marchand |
|---|---|---|---|
| GMKtec EVO-X2(Ryzen AI Max+ 395) | 128 GB、SSD 2 TB | 3 449,99 € | gmktec.fr |
| Minisforum MS-S1 MAX(Ryzen AI Max+ 395) | 128 GB、SSD 2 TB | 4 159,00 € | minisforumpc.fr |
| AI TOP ATOM ATAGB10-9001 | 128 GB、SSD 4 TB PCIe 4.0 | 6,346.27 €(10月8日時点で売り切れ) | AORUS公式ストア(Amazon.frで在庫あり) |
| MSI EdgeXpert(GB10) | 128 GB、SSD 4 TB | 6,599.95 €(10月8日時点で在庫切れ) | Materiel.net |
| AI TOP ATOM ATAGB10-9000 | 128 GB、SSD 4 TB PCIe 5.0 | 7,999.95 €(10月8日時点で在庫切れ) | LDLC, Materiel.net |
| Mac Studio M5 Max(CPU 18コア、GPU 40コア) | 128 GB、SSD 512 GB | 5 859 € | apple.com/fr |
| Mac Studio M5 Max(CPU 18コア、GPU 40コア) | 128 GB、SSD 4 TB | 7,839 €(計算値) | apple.com/fr、ストレージオプション |
Ryzen AI Max+ 395 は最も安価なマシンです。ストレージを 4 TB でそろえると、ATOM 9000(PCIe 5.0 SSD、私たちが測定したモデル)と Mac Studio M5 Max は同じ価格帯に入ります。PCIe 4.0 SSD を搭載した ATOM 9001 は、表中で最も安価な 128 GB の GB10 マシンです。私たちの知る限り、チップとメモリは同じです。
SSD が主に影響するのはモデルの読み込み時間であり、計算速度ではありません。SSD の測定値は 9000 モデルのものです。Mac Studio M5 Max の価格も掲載しているのは、公開データで測定されたマシンと同じチップを使用しているためです。その速度は本ガイドでは測定していません。
二つのATOMモデルの特徴は、容量一リットル(1.2 kg)の筐体と、冷却・仕上げ・型番といったGIGABYTE独自の選択にあります。
#この比較からわからないこと
- 測定データの出典
- Ryzen AI Max+ 395(128 GBのFramework Desktop)とMac M5 Maxの数値は、ビルドと日付が明記された公開資料に基づくものです。価格表に掲載したミニPCは測定していません。10 %未満の差は同等とみなしてください。ビルドは変わりますし、同じモデルでも二台の個体間で数パーセントの差が出ます。
- Apple の MLX エンジンは測定していません
- Macでは、MLXを使うとllama.cppやOllamaとは異なる速度になる場合があります。この違いについては、MLXとllama.cppを比較したガイドで詳しく説明しています。
- Macとの共通モデルは一つのみ
- M5 Max について公開されている llama-bench 形式の結果は llama 7B のみです。大型モデルについては、ある読者による Ollama の測定しかありません。
- 回答の品質
- このガイドは速度を比較するものであり、モデルの品質を比較するものではありません。
- 他のマシンでの複数ユーザー利用と学習
- 当サイトでは、RyzenでもMacでもこれらを測定していません。Ryzenについては、StorageReviewの結果を引用しています。
更新と訂正:llama.cpp の新しいビルドや新たな公開データによってこれらの結果が変わった場合、このページを改訂します。各訂正には日付を記載します。
#ATOMが適している人
以下の内容は、ATOMでの当社の測定結果と、前述の公開値に基づいています。
- 長文ドキュメントやコードを読み込ませるなら、ATOMが最適です
- 32,768トークンがメモリにある状態でgpt-oss 120BをRyzen AI Max+ 395の2.8倍の速さで読み込み、30,000トークンのドキュメントを21.8秒で読み込みます。
- …複数の人やエージェントでマシンを共有する場合
- gpt-oss 120Bで16ユーザー合計160.3トークン/秒。より長いリクエストでも、スループットは1時間にわたって124.8トークン/秒を維持し、低下はありませんでした。
- …モデルの学習や調整を行う場合
- 700億パラメータのモデルに対するQLoRAは41.3 GBに収まります。請求書を対象としたLoRAには85分かかりました。
- …容量一リットルの筐体で大型のMoEモデルを動かしたい場合
- gpt-oss 120Bは、重さ1.2 kgのマシンで58.8トークン/秒の書き出し速度を実現します。
- 一人で使い、小規模な密モデルで書き出しを行うなら、Mac M5 Maxの方が適しています
- llama 7Bでは書き出しが約二倍速くなります(119.9対59.4トークン/秒)。
- 予算が決め手なら、Ryzen AI Max+ 395搭載のミニPCがより適しています
- MoEモデルでは書き出し速度は近い水準にとどまり、価格は3,449.99 €からですが、読み込みは2.1~2.8倍遅くなります。
まとめ:長いテキストを読み込ませる作業が中心なら、当サイトの比較に基づくとATOMが適しています。複数人へのサービス提供や学習についても、ATOM自体の測定結果は堅実です。16ユーザーで合計毎秒160.3トークン、700億パラメータのQLoRAを41.3 GBで実行できました。小さな密モデルを使って一人で生成するならMacを、予算が決め手ならRyzenを検討してください。
#FAQ
GB10、Ryzen AI Max+ 395、Mac M5 Maxのうち、最も速いマシンはどれですか?+
AI TOP ATOMはMac M5 Maxより速いですか?+
同じマシンの数値がサイトによって異なるのはなぜですか?+
自分のマシンをこれらの数値と比較するにはどうすればよいですか?+
Ryzen AI Max+ 395はGB10と比べて良い選択ですか?+
ご意見、誤りのご指摘、補足はありますか?ぜひお知らせください。皆さんにとってより良いガイドにするために役立ちます。