GB10で70B LLMをローカル実行:チュートリアル complet
GIGABYTE AI TOP ATOM(NVIDIA GB10チップ、128 GB)では、Llama 3.3 70Bは余裕をもって収まります:コンテキスト8,192トークンで43.6 GB、131,072トークンで82 GBです。三つの方式(Ollama、llama.cpp、vLLM)で毎秒4.6~5.3トークンを生成します。Llama 3.2 1Bのドラフトを使うと、llama.cppは文章で毎秒12トークン、コードで毎秒19トークンに達します。八人のユーザーでは、vLLMは二時間にわたり平均で合計毎秒38.6トークンを維持します。
Llama 3.3 70B のような 700 億パラメーターのモデルは「密(dense)」モデルです。一語を生成するたびにすべてのパラメーターを使用するため、大量のメモリを必要とします。GB10 マシンの 128 GB には十分な余裕をもって収まります。このチュートリアルでは、GIGABYTE から無償で提供された AI TOP ATOM でテストした三つのインストール方法のコマンドを紹介し、続いて選択の助けとなる測定結果(速度、小型ドラフトモデル、コンテキストのメモリ、二時間の安定性、複数ユーザーへのサービス)を示します。
#マシン、手法、単位
まず、いくつか用語を説明します。トークンとは単語の断片のことです。フランス語では、トークン一つがおよそ単語の三分の二に相当します。コンテキストとは、やり取りの間にモデルが記憶しているテキストのことで、あなたの質問、ドキュメント、そしてモデル自身の回答が含まれます。出力速度は回答が表示されるペースで、毎秒あたりのトークン数(tok/s)で表します。読み込み速度は、回答する前にマシンがあなたのテキストを取り込むペースです。
マシンはGIGABYTE AI TOP ATOM(型番ATAGB10-9000)です。NVIDIA GB10チップは20基のArmコアとBlackwell GPUを統合しており、両者が273 GB/sの128 GBメモリを共有します。SSDはPCIe 5.0の4 TBです。OSはDGX OS 7.5.0で、これはUbuntuをベースとしたNVIDIAのシステムです(ドライバ580.159.03、CUDA 13.0)。システム上で認識されるメモリは121.7 GBです。
- NVIDIA GB10 プラットフォームに由来するもの
- 本ガイドの速度は、チップ、273 GB/sの128 GBメモリ、そしてDGX OSによって決まります。NVIDIAのDGX Spark向けに公開されている二つのリファレンス結果をllama.cppとOllamaで再現したところ、当サイトの速度との差は最大でも4.3 %でした。したがって当サイトの知る限り、これらの速度は128 GBを搭載した他のGB10マシンにも当てはまるはずです。本ガイドの測定値はAI TOP ATOMで取得したものです。
- GIGABYTE が提供するもの
- 約一リットルの筐体とその冷却、仕上げ、モデル構成(9000はPCIe 5.0の4 TB SSDを搭載)、販売店の保証です。二時間の連続稼働中、GPUは72 °Cを超えず、スロットリングも一切発生しませんでした。
測定は 2026年10月6日・7日に実施しました(Open WebUI を使ったプライベートアシスタントは 10月7日・8日)。プロトコルは最初の測定前の 10月6日 13 時 30 分に確定しました。投機的デコードとメモリ予算は、対象となる試験の前に作成された日付付きの追補によって追加されています。表の手法とデータは、当サイトの手法ページで公開しています。
llama.cppとTensorRT-LLMの生成速度は、400トークンのテキスト六本から得たものです:フランス語の散文が三本、コードの依頼が三本です。Ollama(300語のテキスト一本)とvLLM(入力1,024トークン、出力256トークンのランダムなリクエスト)の速度は、それぞれのセクションで説明しているプロトコルに従っています。温度は0に固定しています:モデルは常に最も確率の高い語を選ぶため、試験同士を比較できます。各種類について、三本のテキストの中央値を公開しています。
メモリサイズは GB 単位で表記しています(Linux の表示と同じく 1 GB = 1 024 MB)。GB/s 単位の帯域幅はメーカー公表値で、十進単位です。使用したバージョンは llama.cpp b11430(2026年十月5日ビルド)、Ollama 0.34.1、vLLM 26.09、TensorRT-LLM 1.3.0rc12 で、後者の二つは NVIDIA のコンテナ内で使用しています。本シリーズの最初のガイドでは、Llama 3.3 70B を含む 13 モデルの測定結果を紹介しています。本ガイドでは、そのインストール方法と高速化の方法を説明します。
#方法 1:Ollama、最もシンプルな方法
Ollama は最も手軽に始められる方法です。アーカイブを一つ展開し、一つのコマンドでモデルをダウンロードし、もう一つのコマンドで対話します。私たちはバージョン 0.34.1 を Linux Arm 向けの公式アーカイブからフォルダーにインストールし、システムサービスは使用しませんでした。通常のインストーラーを使いたい場合は、Linux へのインストールガイドで説明しています。
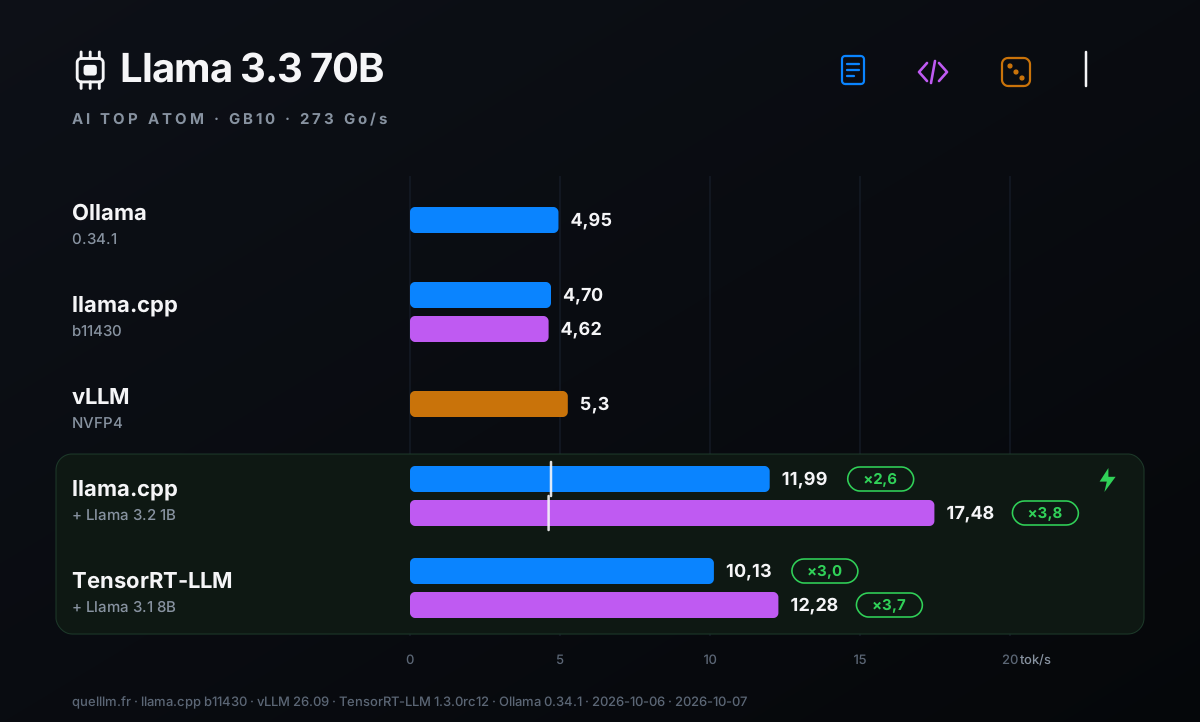
--verbose オプションを付けると、応答の最後に統計情報が表示されます。当方の環境では、Llama 3.3 70B(重みを圧縮する Q4_K_M 形式)の生成速度は初回が 4,97 tok/s、二回目が 4,95 tok/s でした。ollama ps コマンドでは、十進単位で 85 GB が読み込まれていると表示されます。Ollama が自動的に 131 072 トークンのコンテキストを確保していたためです。18 823 トークンのテキストでは、読み込みに 55,6 秒(338,7 tok/s)かかり、その後の生成は 4,38 tok/s にとどまります。
これらの数値の位置づけとして:Ollamaは、NVIDIAのDGX Spark上でのLlama 3.1 70B Q4_K_Mの結果を4.423 tok/sと公表しています(バージョン0.12.6、2025年10月23日)。同じバージョン、同じスクリプト、同じモデル(Llama 3.1 70B)で、当社のATOMは4.34 tok/sとなり、差は2%以内です。コンテキストと使用メモリを減らすには、サーバーを起動する前に変数OLLAMA_CONTEXT_LENGTHを設定してください。このバリエーションは測定していません。
#方法 2:llama.cpp(最も多くの設定が可能な方法)
llama.cpp は広く使われているオープンソースのエンジンです。GGUF 形式のモデルを読み込みます。GGUF は重みを格納した単一のファイルです。GB10 チップ向けに一度コンパイルする必要がありますが、コンテキストのサイズ、コンテキストキャッシュの形式、ドラフトモデルといったすべての設定を利用できます。コンパイルは NVIDIA のガイドに沿って行い、GB10 のアーキテクチャである CUDA 121a-real を指定しますが、libcurl(-DLLAMA_CURL=OFF)と RPC は使用しません。
選択したファイルは、bartowskiが公開している Llama 3.3 70B の Q4_K_M 版で、サイズは39.6 GBです。ディスクキャッシュを空にした状態で、llama.cppはSSDから8秒で読み込みます。hfコマンドはhuggingface_hubライブラリに含まれています(インストール:pip install -U huggingface_hub)。Hugging Faceで Llama ライセンスへの同意を求められた場合は、サイト上で同意してから、hf auth login でログインしてください。
- -ngl 99
- モデルのすべてのレイヤーを GPU に配置します。
- -fa on
- Flash Attention を有効にし、コンテキストの読み込みをより効率的にします。
- -lm dio
- システムのキャッシュ(mmap)を経由せず、ディスクへの直接アクセスでファイルを読み込みます。これは、llama.cppプロジェクトがDGX Spark向けに公開している参照表で使われているモードです。
- -c 16384 -np 1
- 一人のユーザーあたり 16,384 トークンのコンテキストです。指定したコンテキストは同時接続ユーザー間で共有されます。
- --host 127.0.0.1
- サーバーにはマシン自身からしか接続できません。
六つのテキストで、llama-server の生成速度は文章で 4.70 tok/s、コードで 4.62 tok/s でした。計測ツール llama-bench では、生成(32 トークン)で 4.8 tok/s、読み込み(2,048 トークン)で 405 tok/s でした。8,192 トークンのコンテキストでのモデルのメモリ使用量は 43.6 GB です。
目安として、メモリの読み出し速度は最大で毎秒2,730億バイトで、各トークンの生成にはモデルの重み、つまり425億バイトを読み直す必要があります。理論上の最大値は6.4 tok/sで、実測値はその約四分の三に達します。
#方法 3:複数ユーザー向けの NVFP4 での vLLM
vLLM est un serveur conçu pour répondre à plusieurs personnes en même temps. NVIDIA le fournit dans un conteneur, c'est-à-dire un programme isolé que lance Docker. Le modèle est Llama 3.3 70B en NVFP4, un format 4 bits de NVIDIA que les puces Blackwell calculent directement : il occupe 39,9 GB en mémoire. La matrice des modèles pris en charge dans le guide vLLM de NVIDIA pour DGX Spark liste ce modèle.
--max-model-len 8192 と --max-num-seqs 16 の設定により、コンテキストは 8,192 トークン、同時に処理されるリクエストは 16 件に制限されます。--gpu-memory-utilization 0.85 の設定は vLLM が確保するメモリの割合を決めます。ここでは 103 GB で、そのうち 59.6 GB がキャッシュです。このキャッシュは同時に 390,352 トークンを保持でき、これは 8,192 トークンのリクエスト約 48 件分に相当します。初回の起動には約 7 分かかります。内訳はモデルの読み込みに 4 分 20 秒、その後の準備に約 2 分です。
ユーザー一人の場合、vLLM の書き出し速度は 5.3 tok/s(三回の計測で 5.26、5.27、5.26)で、最初の語は平均 0.73 秒で届きます。同時ユーザー八人では、最初の語を待つ時間を含めてマシン全体で 37.7 tok/s を書き出し、応答が始まった後は各ユーザーが 5.0 tok/s で受け取ります。
最初の語は平均 2.8 秒で届き、最も遅いケースでも 4.8 秒未満です。このテストのリクエストは入力 1,024 トークン、出力 256 トークンで、各点は三回ずつ測定しています。
#三つの方法の比較
| 経路 | 生成 | メモリ | 設定 | 選択に適した用途 |
|---|---|---|---|---|
| Ollama 0.34.1(Q4_K_M) | 4,95 | Ollama が表示する 85 GB(十進単位。本ガイドの単位では約 79 GB)、設定なしで確保される 131 072 トークンのコンテキストの場合 | peu | すぐに始める |
| llama.cpp b11430(Q4_K_M) | 文章で4.70、コードで4.62 | 8,192 トークンで 43.6 GB、32,768 トークンで 51.3 GB | すべて:コンテキスト、キャッシュ、ドラフト | ユーザー一人、ドラフトあり |
| vLLM 26.09(NVFP4) | 5.3、ユーザー 8 人で合計 37.7 | 設定値 0.85 で 103 GB を確保 | サーバーのもの | 複数ユーザー |
三つの方法はいずれもほぼ同じ速度で出力し、差は15 %未満です。理由は単純です。チップはトークンごとにモデルの重みを読み直すため、密なモデルの速度を決めるのは273 GB/sのメモリ帯域幅です。そのため70Bの出力速度は約5 tok/s、つまり毎分約200語で、落ち着いて読むくらいのペースです。
このペースは、時間に余裕のある処理に適しています:要約、抽出、校閲、返信の下書きなどです。テンポのよい会話を実現するには、次のセクションで紹介する二つの手段があります:ドラフトモデルと、各トークンでパラメータの一部しか使用しないMoE(mixture of experts)モデルです。
#小さなドラフトモデルで70Bを高速化する
投機的デコーディングでは、ドラフトと呼ばれる小さなモデルが数語先まで提案します(正確にはトークンですが、簡単のため「語」と呼びます)。大きなモデルはこれらの語を一回のパスで検証します。かかる時間は一語を書き出すのとほぼ同じです。時間の大半は重みの読み込みに費やされるためです。
正しい語は残され、それ以外は破棄されます。ドラフトがテキストを選ぶわけではなく、検証するのは常に大きなモデルです。NVIDIA は DGX Spark 向けガイドでこの原理を説明しており、LMSYS のブログは、この手法によってマシンの帯域幅の制約が部分的に緩和されると指摘しています。
#llama.cpp の場合:Llama 3.2 1B をドラフトに使用
ドラフトは大きなモデルと同じ言語を話す必要があります。つまり、同じトークン分割を使う必要があります。Llamaファミリーが適しています:Q8_0のLlama 3.2 1BをLlama 3.3 70Bと組み合わせます。必要なオプションは四つだけです:-mdでドラフトを指定し、--spec-type draft-simpleで方式を選択し、--spec-draft-n-maxで先回りして提案するトークン数(本ガイドでは「単語」と呼びます)を設定し、-ngld 99でドラフトをGPUに配置します。
| 構成 | フランス語の文章 | コード | 受理率(散文/コード) |
|---|---|---|---|
| 70B単体 | 4,70 | 4,62 | — |
| + ドラフト Llama 3.2 1B、8 語先まで提案 | 11,99 (×2,6) | 17,48 (×3,8) | 33 % / 50 % |
| + ドラフト Llama 3.2 1B、16 語先まで提案 | 10,84 (×2,3) | 18,65 (×4,0) | 19 % / 34 % |
10億パラメータのドラフトにより、70Bは2.6~4倍高速になります:文章で12 tok/s、コードで最大19 tok/sです。効果はテキストによって異なります。三つのコードテキストでは、先行8単語で速度は13.2~18.0 tok/sでした。ドラフトの提案は、文章(採用率33%)よりもコード(採用率50%)のほうが多く採用されます。
当社のテキストは、文章はフランス語、コードは英語です。別のテキストでは異なる効果が得られます。文章では、先行8単語のほうが16単語より良い結果でした(11.99対10.84)。コードでは16単語のほうがやや上回りました(18.65対17.48)が、テキスト間の差も同程度です。まずは8から始めてください。
モデル自体が複数トークン予測モジュール(MTP)を備えている場合は、二つ目のファイルなしで同じ原理を利用できます。Qwen3.8 27Bと--spec-type draft-mtpオプションを使うと、llama.cppは文章で11.71から21.48 tok/s(×1.8)、コードで11.59から27.23 tok/s(×2.3)に向上します。
#TensorRT-LLM の場合:NVIDIA の Draft-Target レシピ
TensorRT-LLM は、モデルを最適化して提供するための NVIDIA のライブラリです。DGX Spark 向けガイドでは Draft-Target 方式が紹介されており、FP4 の Llama 3.3 70B に、ドラフトとして FP4 の Llama 3.1 8B を組み合わせます。両モデルとも NVIDIA が提供しています。コンテナのバージョン 1.3.0rc12 では、この設定値はアンダースコア付きの Draft_Target と記述します。
| 構成 | フランス語の文章 | コード |
|---|---|---|
| + ドラフト Llama 3.1 8B FP4、4 語先行 | 10.13(ドラフトなしの同じエンジンと比べて ×3.0) | 12,28 (×3,7) |
TensorRT-LLMでは、ドラフトなしの同じエンジンと比べて、ドラフトモデルにより速度が散文で3.0倍、コードで3.7倍になります。このとき70Bは、散文で毎秒10.1トークン、コードで毎秒12.3トークンを生成します。
したがって、llama.cpp と TensorRT-LLM の二つの方法は、いずれも 2.6~4 倍という同程度の向上をもたらします。ユーザーが一人の場合は llama.cpp が最もシンプルで、ドラフトファイル一つとオプション四つだけで済みます。NVIDIA が提供する FP4 モデルを使った NVIDIA の公式レシピに従いたい場合は、TensorRT-LLM を選んでください。
#コンテキストのメモリ予算(8,192〜131,072 トークン)
コンテキストにはメモリのコスト、つまりKVキャッシュがかかります。これは、モデルが既に読み込んだ内容を再計算しないように保持しておくメモリです。コンテキストが長くなるほど大きくなります。llama.cppはこのキャッシュ全体を読み込み時に確保するため、読み込み後の使用メモリがそのまま最終的な使用メモリになります。
ディスクキャッシュを消去した後、利用可能メモリ(Linux の MemAvailable)の減少量で測定しています。-ctk q8_0 -ctv q8_0 オプションはキャッシュを 16 ビット(f16)ではなく 8 ビットで格納し、キャッシュを軽量化します。表とグラフでは、8k は 8,192 トークン、32k は 32,768 トークン、64k は 65,536 トークン、128k は 131,072 トークンのコンテキストを指します。
| モデル | Cache | 8 192 | 32 768 | 65 536 | 131 072 |
|---|---|---|---|---|---|
| Llama 3.3 70B Q4_K_M | f16 | 43,6 | 51,3 | 61,4 | 81,9 |
| Llama 3.3 70B Q4_K_M | q8_0 | 42,3 | 46,4 | 52,2 | 63,1 |
| gpt-oss 120B MXFP4 | f16 | 61,0 | 61,9 | 63,0 | 65,6 |
| gpt-oss 120B MXFP4 | q8_0 | 60,7 | 61,3 | 62,1 | 63,2 |
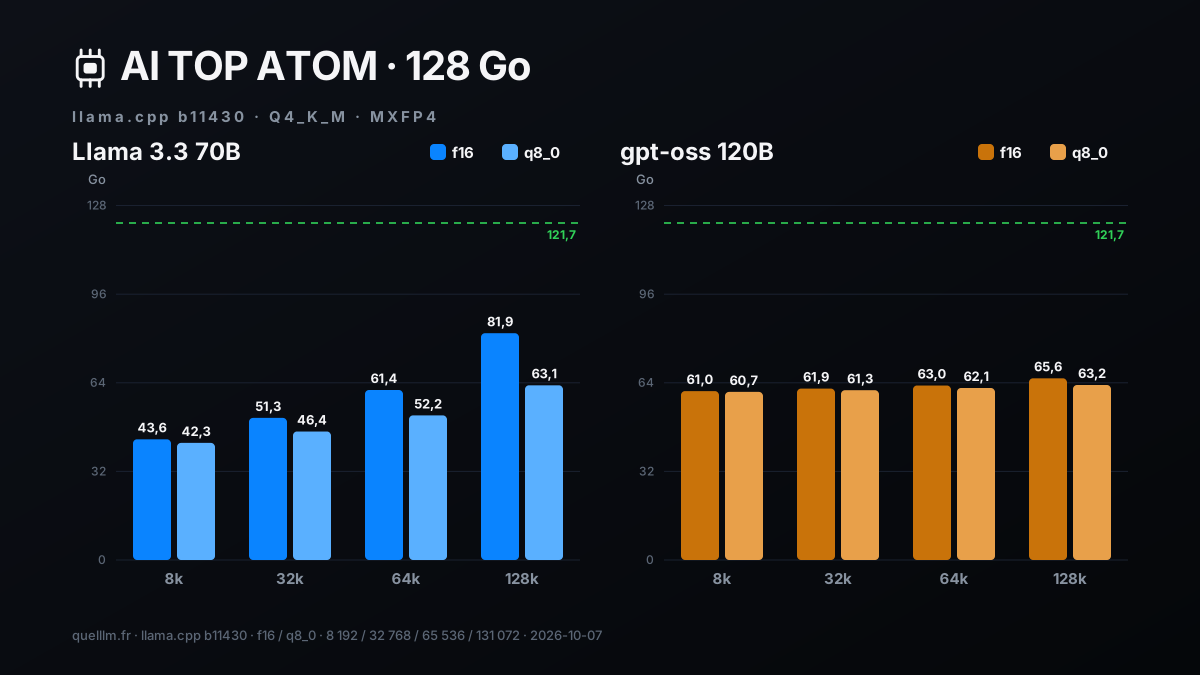
すべて 121.7 GB に収まります。f16 で 131,072 トークンのコンテキストを使う 70B でも 81.9 GB です。70B では、8k から 128k にかけてコンテキストによる増加が f16 で 38 GB、q8_0 では 21 GB と、ほぼ半分になります。gpt-oss 120B の増加は 4.6 GB にすぎません。テキスト全体を参照する層と、短いウィンドウだけを参照する層を交互に配置しているためです。q8_0 形式の代償は速度がやや下がることで、70B の 128k では 9〜11 % 低下します(次の表)。
また、満杯に近いコンテキストでの読み込みと生成を測定するため、Service-Public の実用情報シートでコンテキストを 90 % まで埋めました。128k では、テキストは 70B で 117,605 トークン、gpt-oss 120B で 117,889 トークンとなり、約 200 ページに相当します。
| モデル | Cache | 読み込んだテキスト(トークン) | メモリ(GB) | Lecture | 生成 |
|---|---|---|---|---|---|
| Llama 3.3 70B | f16 | 29 214 (32k) | 51,4 | 286,1 (102 s) | 4,22 |
| Llama 3.3 70B | q8_0 | 29 214 (32k) | 46,5 | 271,1 (108 s) | 4,02 |
| Llama 3.3 70B | f16 | 117 605 (128k) | 82,0 | 181,9 (646 s) | 2,86 |
| Llama 3.3 70B | q8_0 | 117 605 (128k) | 63,2 | 164,6 (715 s) | 2,54 |
| gpt-oss 120B | f16 | 29 227 (32k) | 61,7 | 1 443 (20 s) | 43,81 |
| gpt-oss 120B | q8_0 | 29 227 (32k) | 61,2 | 1 401 (21 s) | 43,96 |
| gpt-oss 120B | f16 | 117 889 (128k) | 65,4 | 1 073 (110 s) | 26,93 |
| gpt-oss 120B | q8_0 | 117 889 (128k) | 63,4 | 993 (119 s) | 24,97 |
フルコンテキストでもすべて動作します。gpt-oss 120Bは200ページのテキストを110秒で読み込み、その後も約27 tok/sで生成を続けます。70Bは117,605トークンを182 tok/sで読み込みます。非常に長い文書には、読み込みでも生成でもMoEモデルのほうが高速です。
#八人のユーザーによる二時間のサービス運用
サーバーは長時間安定して動作する必要があります。vLLM 26.09でNVFP4のLlama 3.3 70Bを起動し、二時間にわたってリクエストを送信しました:八人のユーザーが連続して、入力1,024トークン・出力256トークンのリクエストを32件ずつ送信しました。チップのログを毎秒一回記録し、GPUの電力、周波数、温度を追跡しました。
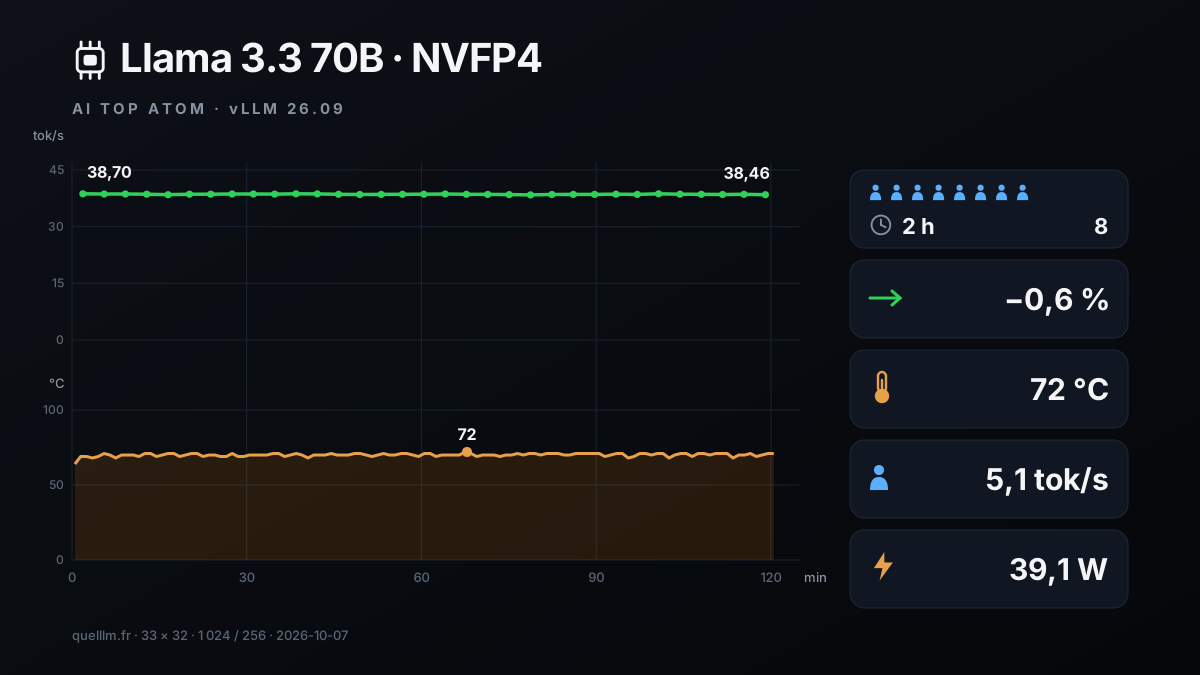
結果は単純で、速度は変わりませんでした。総スループットは最初の区間の38.70 tok/sから最後の区間の38.46まで、最小38.40、最大38.70で、差は−0.6 %です。各ユーザーには5.1 tok/sが割り当てられます。最初の語が届くまでの時間は中央値で2.8秒、区間によって2.4〜2.9秒でした。
合計で、マシンは1,056件のリクエストを処理し、1,081,344トークンを読み込み、270,336トークンを生成しました。エラーは一件もありませんでした。GPUの温度は最高でも72 °Cにとどまりました。周波数の中央値は2,528 MHzで、二時間の記録期間中、スロットリングの理由は一つも記録されませんでした。
GPU の平均消費電力は 39.1 W、ピークは 95.0 W でした。これらのワット数はチップから読み取った GPU のみの値で、プロセッサー、メモリ、SSD、電源は含まれません。二時間で GPU の消費電力量は 78.8 Wh となり、EDF Tarif Bleu Base(6 kVA)の料金(1 kWh あたり 20.01 サンチーム)で 1.6 サンチームに相当します。
#サーバーとして使う:OpenAI API、キー、Open WebUI
OpenAI API とは、コードエディター、チャットインターフェース、スクリプトなど、多くのツールが扱えるリクエスト形式です。llama-server と vLLM はどちらもこれを提供しています。これを保護するため、llama-server は --api-key オプションでキーを受け付けます。キーがない場合は 401 エラーを返します。これら三つの呼び出しは gpt-oss 20B で検証しました。70B の場合も、ファイルが異なるだけで同じコマンドです。
一回目の呼び出しは401を返し、二回目は提供中のモデルの一覧を、三回目はOpenAI形式の応答を返します。--jinja オプションは、モデルファイルに含まれる会話テンプレートを適用します。
チャットインターフェースとしては、Open WebUIをこのAPIに接続します。以下は、gpt-oss 120Bを使った当社のプライベートアシスタントのテスト(本シリーズの別のガイド)のスタックです。モデルサーバーは、インターネットにアクセスできない内部Dockerネットワーク内にあります。Open WebUI 0.11.4は、このネットワークとアクセス用ネットワークの両方に接続されています。
これにより、モデルは外部への出口を一切持ちません。サーバーにはキーを設定していません。内部ネットワークからしかアクセスできないためです。OPENAI_API_KEY の値 local は、Open WebUI の要件を満たすためだけのものです。代わりに 70B を提供するには、ファイルパスを Llama-3.3-70B-Instruct-Q4_K_M.gguf のパスに置き換え、-c と -np を前述のメモリ予算に合わせて調整してください。
次に、マシン上のブラウザで http://127.0.0.1:3100 を開くと、一覧にモデルが表示されます。当社のプライベートアシスタントのテストでは、埋め込みサーバー(bge-m3)を加えたスタック全体が66秒で準備完了しました。NVIDIA のllama.cppガイドによると、Open WebUI、Continue.devなどのクライアントがこのAPIに接続できます。このAPIはOpenAI APIの形式に従っています(サーバーのアドレスの後に/v1)。
#高速な代替案:120BのMoEモデル
MoE(mixture of experts)モデルは多数のパラメータを持ちますが、各トークンではその一部しか使用しません。gpt-oss 120B は1170億パラメータのうち51億がアクティブで、OpenAIはこれをMXFP4形式で直接公開しています。
GB10 では、計測ツール llama-bench で 58.0 tok/s(32 トークンの生成)、llama-server での長い応答では文章でもコードでも 54.4 tok/s の速度で生成します。これは密な 70B の 11 倍以上の速度で、メモリ使用量は 8,192 トークンで 61.0 GB、131,072 トークンで 65.6 GB です。
速度は品質について何も示しません。二つのモデルの回答は比較していません。選び方は次のとおりです。速度が重要な会話、エージェント、長い文書には gpt-oss 120B を選んでください。Llama 3.3 70B は、そのモデルそのものが必要な場合(たとえばこのモデルをもとに調整されたモデルを使う場合)や、5 tok/s で十分なバッチ処理に選んでください。4B から 235B までの 13 モデルの測定結果は、本シリーズの最初のガイドに掲載しています。
#このガイドで測定していないもの
- 回答の品質
- 当社が測定しているのは速度とメモリであり、各モデルの価値ではありません。
- 他のテキストにおけるドラフトの効果
- 当方の六つのテキストは、文章部分がフランス語、コードが英語です。効果はテキストと言語によって異なります。
- 131,072 トークンを超えるコンテキスト
- これらのメモリ使用量も速度も測定していません。
- その他のGB10マシンと64 GB版
- ATOM 128 GB での当方の測定結果は、DGX Spark について公開されている参考値と一致しています。
- マシン全体の消費電力
- 記載のワット数はGPUのもので、チップから読み取った値です。
更新と修正:DGX OS、llama.cpp、Ollama、vLLM、TensorRT-LLMの新しいバージョンによってこれらの結果が変わった場合、このページを改訂します。各修正には日付を記載します。
#ATOMが適している人
以下は、128 GB の GB10 マシンである ATOM での当方の測定結果です。
- 700億パラメータのモデルを自宅で動かしたいなら、ATOMが適しています
- 余裕を持って収まります。コンテキストが8,192〜131,072トークンの場合、使用量は121.7 GB中43.6〜82 GBで、三つのインストール方法がいずれも動作します。
- …複数の人やエージェントでモデルを共有する場合
- 八人のユーザーで、短い試行では合計 37.7 tok/s、二時間では平均 38.6 tok/s が得られ、エラーは一切発生しませんでした。
- …マシンを替えずに高速化したい場合
- 小さなドラフトにより、llama.cppでもNVIDIAのレシピでも、70Bの速度は2.6~4倍になります。
- …高速な会話や長い文書を扱いたい場合
- gpt-oss 120B は54.4 tok/sで生成し、200ページを110秒で読み込みます。
- … NVIDIA エコシステムを使って作業する場合
- 私たちの環境では、DGX OS 7.5.0 上で CUDA 13、NVIDIA のコンテナに含まれる vLLM と TensorRT-LLM、および GB10 向けにコンパイルした llama.cpp が動作しました。
GIGABYTE側では、約一リットルの筐体で、二時間の連続負荷の間、GPUは最高でも72 °Cに保たれ、スロットリングは発生しませんでした。GB10マシンの価格は毎週変動します。購入前にマシンの製品ページで確認してください。
#FAQ
128 GBのGB10マシンで70Bモデルを動かせますか?+
AI TOP ATOMで70Bはどのくらいの速度で生成しますか?+
Ollama、llama.cpp、vLLMのどれを選ぶべきですか?+
マシンを変えずに70Bを高速化するにはどうすればよいですか?+
70Bで複数の人に何時間もサービスを提供できますか?+
70BのdenseモデルよりもMoEの120Bモデルを選ぶべきですか?+
ご意見、誤りのご指摘、補足はありますか?ぜひお知らせください。皆さんにとってより良いガイドにするために役立ちます。