ホーム › レビュー・テスト › GLM コーディングプラン
GLM Coding Plan:テスト後の評価
コードアシスタント向けに設計されたGLMモデルへのAPIアクセス。モデルの重みをオープンウェイトとして公開する研究機関が提供しています。
コードアシスタントを大規模モデルに接続する用途では、現時点で最もコストパフォーマンスの高い選択肢です。その理由は、まさにモデルの重みが公開されており、ローカルでの実行に切り替える道が残されていることにあります。ただし、懸念は確かにあります。プランの利用上限が不透明だと感じている契約者もいます。
具体的には、どのようなものですか?
GLMは、中国の研究機関Zhipu AI(国際ブランド名:Z.ai)が開発するモデル群です。Zhipu AIは2026年1月から香港に上場しています。GLMの特徴であり、本サイトが数か月にわたって取り上げている理由は、モデルの重みがオープンウェイトとして公開されていることです。GLM-5、GLM-5.1、GLM-5.2は、必要なVRAM容量とともに当サイトのカタログに掲載されています。
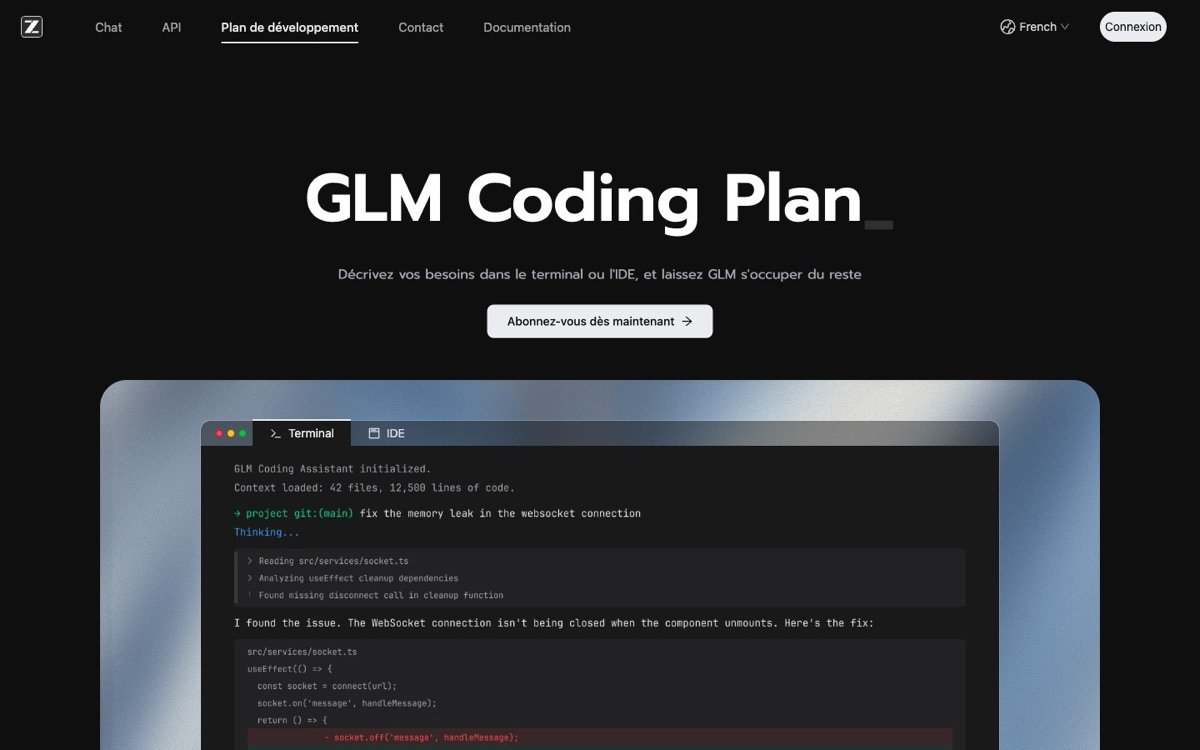
Coding Planはコーディング向けのAPIサブスクリプションです。既存のアシスタント(Claude Code、Cline、Roo Code)と互換性のあるプロトコルを通じてGLMモデルを提供し、同等の米国製APIよりも大幅に安い料金で利用できます。考え方はシンプルです。コーディングツールは違いを認識しませんが、請求額には違いが表れます。
当サイトのテスト:一般消費者向けGPUでローカル実行するGLMの限界
APIを評価する前に、テストマシン(RTX 5070 Ti 12 GB + Intel Core Ultra 9 275HX、CachyOS、Ollama)でローカル実行の限界まで試しました。これこそ、オープンウェイトのモデルファミリーの利点です。問うべきなのは「APIを使うか、何もできないか」ではなく、「どの時点からAPIが必要になるか」です。測定に基づく答えを、数値とともに示します:
| 測定 (26/08/2026) | 結果 |
|---|---|
| ローカルでテストされたモデル | GLM-4.7-flash(q4 量子化) |
| メモリ使用量 | 20 GB — VRAMが12 GBの場合:CPUに47%をオフロード、GPUに53%を配置 |
| コード生成(Pythonタスク) | 35トークン/秒 — 驚くほどスムーズ |
| プロンプトの処理(prefill) | 5.8トークン/秒 —— 本質的なボトルネック |
| モデルの読み込み | 25 s |
測定結果は「それは成立しない」というような簡易的な評価よりも詳細な物語を語ります。CPUに半分ほどオフロードされた場合でも、モデル 生成します 35トークン/秒で、チャット用途には快適です。しかし、 プロンプト処理 は最大でも5.8トークン/秒です。解析用に2,000トークンのファイルを送るだけで、最初の言葉が出るまで5分以上、何も出力されない状態が続きます。そして、コードアシスタントはまさにこの処理、つまり反復のたびにファイルを読み直すことを繰り返します。
明確な結論:12GBの一般向けGPU上で、このモデルファミリーは ローカルのコーディングエージェントとしては使いものになりません。原因は生成ではなく、プリフィルにあります。Coding Planはまさにこの問題を補います。同じモデル群を瞬時のプリフィルで提供し、その間、お使いのGPUは空いたままです。VRAMが24 GB以上ある場合は、もう一度計算してみてください。 設定ツール はあなたのマシンに提供されます。
料金
Coding Planには、個人利用向けの入門プランから、複数のエージェントを集中的に使うための「Max」まで、複数のプランがあります。2026年8月に確認された料金は、入門プランの月額数ドルから上位プランの数十ドルまでで、AnthropicやOpenAIの同等のサブスクリプションより一桁低い水準です。Z.aiは初月の割引キャンペーンを頻繁に実施しています。価格は急速に変わるため、契約前に現在の価格を確認してください。
強みと課題
- オープンウェイト=ベンダーロックインなし:プロンプト、ワークフロー、さらにはモデル自体も、引き続きローカル環境に取り戻せます
- 既存のコードアシスタント(Claude Code、Cline、Roo Code)と互換性があり、ツールを変更せずに使用可能です。
- 同等の米国製APIよりもはるかに低い最低利用料金
- 基盤のしっかりした企業:香港に上場しているZhipu AIは、オープンモデル分野の主要な研究機関の一つです。
- 一部の契約者は利用枠が不透明だと評価しています(ピーク時間帯には「Claudeの3倍」という説明に異議が出ています)。— Trustpilotでは2026年8月時点で32件のレビューに基づく評価が2.1/5。最初の1週間は使用量を確認してください。
- 同じフィードバックによると、カスタマーサポートの対応が遅い
- リクエストはZ.aiのサーバーを経由します。NDAの対象となるコードには使用すべきではありません。これはどのAPIにも当てはまるため、当サイトでは引き続きローカル実行を基準としています
よくある質問
GLMを無料で利用できるのでしょうか?
はい。GLM モデルはオープンウェイトで公開されており、量子化されたバージョンは Ollama または LM Studio で無料でダウンロード・実行可能です。ただし、VRAM の範囲内でのみ利用可能です。サブスクリプションは、Z.ai のインフラ上で提供される完全バージョンのモデルへの API アクセスにのみ適用されます。
GLM Coding Plan は Claude Code と互換性がありますか?
はい、これはその主な特徴です。APIは互換性のあるプロトコルを提供しており、ツールをZ.aiのエンドポイントに設定するだけで対応できます。ClineおよびRoo Codeもサポートされています。設定には数分かかります。
公表されている利用上限は信頼できますか?
これは文書化された主な懸念事項です。ピーク時間帯に、告知されたよりもクォータの消費が速いという報告が一部の利用者から寄せられており、サービスのTrustpilot評価にも影響が出ています(32件の小さなサンプルで2.1/5)。私たちのアドバイス:エントリーレベルのプランを選び、実際の使用状況を1週間測定してから判断してください。
このプランでは、私のデータはどこに送られますか?
リクエストはZ.aiのサーバーで処理されます。NDAの対象となる非公開の独自コードや、規制の対象となるデータを扱う場合も、原則は変わりません。ローカルモデルを使い続けてください。このモデルファミリーは重みが公開されているため、それが可能です。
GLMをローカルで実行するためにはどのようなマシンが必要ですか?
小型の量子化モデルは、メモリ容量が 8~12 GB の GPU で動作します。最近の MoE モデル(GLM-4.7-flash は q4 で読み込むと約 20 GB。当サイトのマシンで測定)は、さらに多くのメモリを必要とします。当サイトの構成チェックツールでこれを測定でき、お使いのマシンでどこまで動かせるかを具体的に確認できます。